
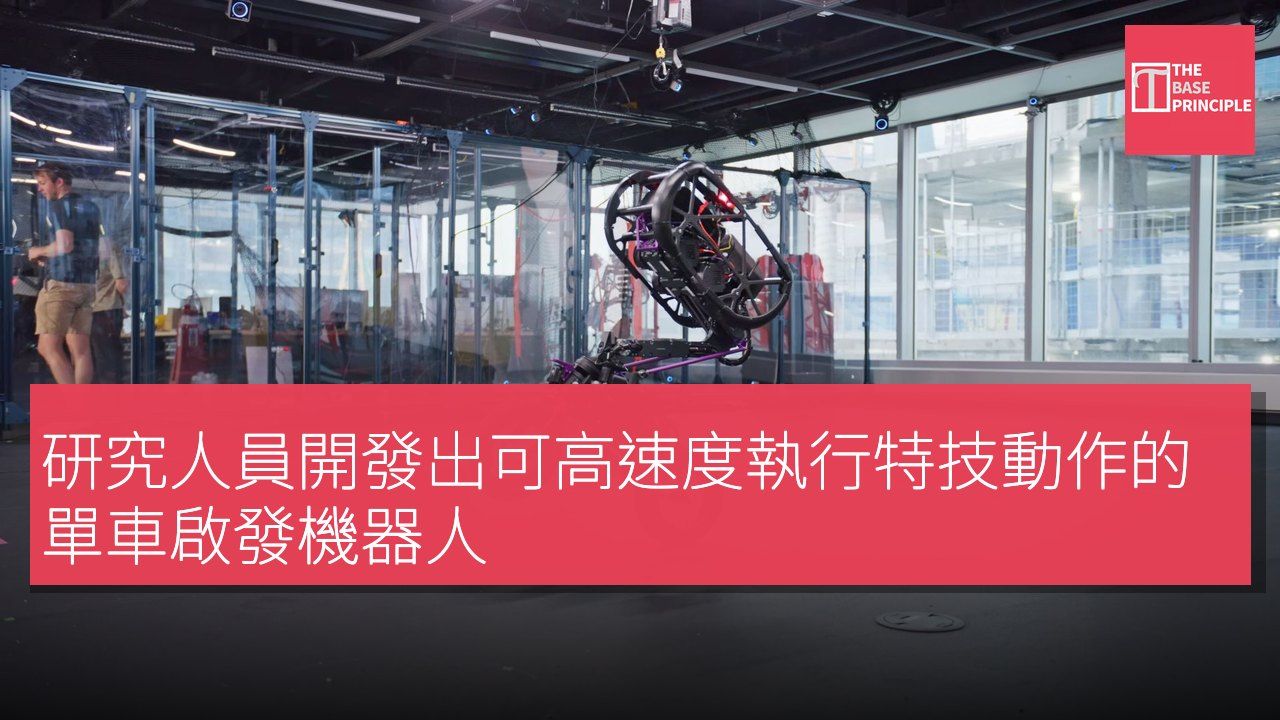
- UMV 是一款受單車啟發的機器人,能在高速下執行雜技動作。
- 這款機器人採用強化學習來訓練,能穿越障礙物。
- UMV 的設計減少了機械複雜性,僅需五個驅動自由度。
- 未來將專注於改進硬件和減少對外部系統的依賴。
研究人員開發出一款受單車啟發的機器人,能在高速下進行雜技動作並保持平衡。這款名為超級移動車(Ultra Mobility Vehicle,UMV)的機器人採用移動反應質量來控制穩定性並執行複雜動作。該機器人可以進行跳躍、單輪行駛、翻轉等動作,靈感來自山地單車和特技單車。研究人員使用強化學習來訓練該機器,使其能夠穿越障礙物並執行動態動作。
在機器人與人工智能研究所(Robotics and AI Institute)中,UMV 被設計為一款基於單車的機器人,旨在將快速的輪式運動與腿部機器的敏捷性結合。這款重 51 磅(23.5 千克)的機器人可以以每秒 8 米(約 18 英里每小時)的速度行駛,並能在後輪上保持平衡,橫跳,進行單輪行駛和前翻。其設計利用可移動的反應質量和強化學習來實現這些動作,僅需五個驅動自由度(DoF),相較於傳統的腿部機器人減少了機械複雜性。
UMV 的設計與結構
UMV 由三個主要結構組件組成:頭部、頸部和單車框架。與傳統單車不同,其頭部容納了大部分機器人的質量,包括計算硬件、電池和強大的跳躍驅動器。連接頭部與單車框架的空間連桿使機器人能在運動中轉移其質量並改變方向。該連桿由頸部和兩根連桿組成,協同工作以控制頭部相對於單車的位置資訊。兩個驅動器驅動主要運動,另一對則通過連桿實現橫向運動。這些機制幫助機器人產生跳躍所需的力量,並在單輪操作時保持平衡。
另外兩個驅動器則控制轉向和後輪驅動,使其能實現類似傳統單車的運動。整個系統使用五個驅動自由度,使其能在沒有反應輪、支架或其他專用靜態穩定機制的情況下執行一系列動態動作。
強化學習的應用
研究人員使用強化學習(RL)來訓練 UMV 在模擬環境中執行不同動作,然後將學習到的控制策略轉移到實體機器人上。訓練過程使用 NVIDIA Isaac Laboratory 和近端策略優化算法(Proximal Policy Optimization)。在訓練期間,模擬環境會變化質量分佈、摩擦、馬達強度、控制延遲和傳感器噪聲等參數。這種領域隨機化旨在幫助學習到的策略處理模擬與實際條件之間的差異。
研究人員開發了四個主要控制策略,用於駕駛、單輪行駛、跳躍和翻轉。這些策略通過低層比例-導數控制器控制機器人的關節運動。最終行為能夠從模擬轉移到硬件上,無需額外訓練。機器人能在向前或向後移動時保持平衡,圍繞後輪原地轉向,並以最小的運動執行追蹤站立。在後輪跳躍時,能夠向不同方向橫移,克服傳統輪式平台的方向限制。
在一項實驗中,UMV 自主接近一個 1 米高的平台,跳上去後在表面上行駛,然後再跳下。它重複這個過程 15 次,在上升過程中展示出穩定的跳躍軌跡。機器人還能通過跳躍並將身體收緊來完成前翻。這個動作減少了其旋轉慣性,使其能更快地旋轉。在這個過程中,其俯仰角速度達到約 17 弧度每秒,機器人在不到半秒內完成旋轉並成功著陸。
未來發展方向
研究人員在實驗室中使用動作捕捉設備對該系統進行測試,以改善狀態估計。未來的開發將專注於更堅固的硬件、改進的電池和馬達驅動器,以及減少對外部動作捕捉系統依賴的板載傳感器。團隊認為該技術在城市配送和越野長途偵察中具有潛在應用,尤其在速度、靈活性和障礙物清除方面尤為重要。
UMV 技術的潛在應用與挑戰
UMV 的設計結合了單車的快速運動和機器人的靈活性,顯示出在動態環境中的優越性能。強化學習的應用使機器人能夠在模擬環境中學習,並有效轉移到實體操作,這對於未來的自動化技術至關重要。隨著技術的進步,研究人員計劃改善硬件和電池,這將使 UMV 更加可靠,並在城市配送和越野偵察等領域發揮更大潛力。