
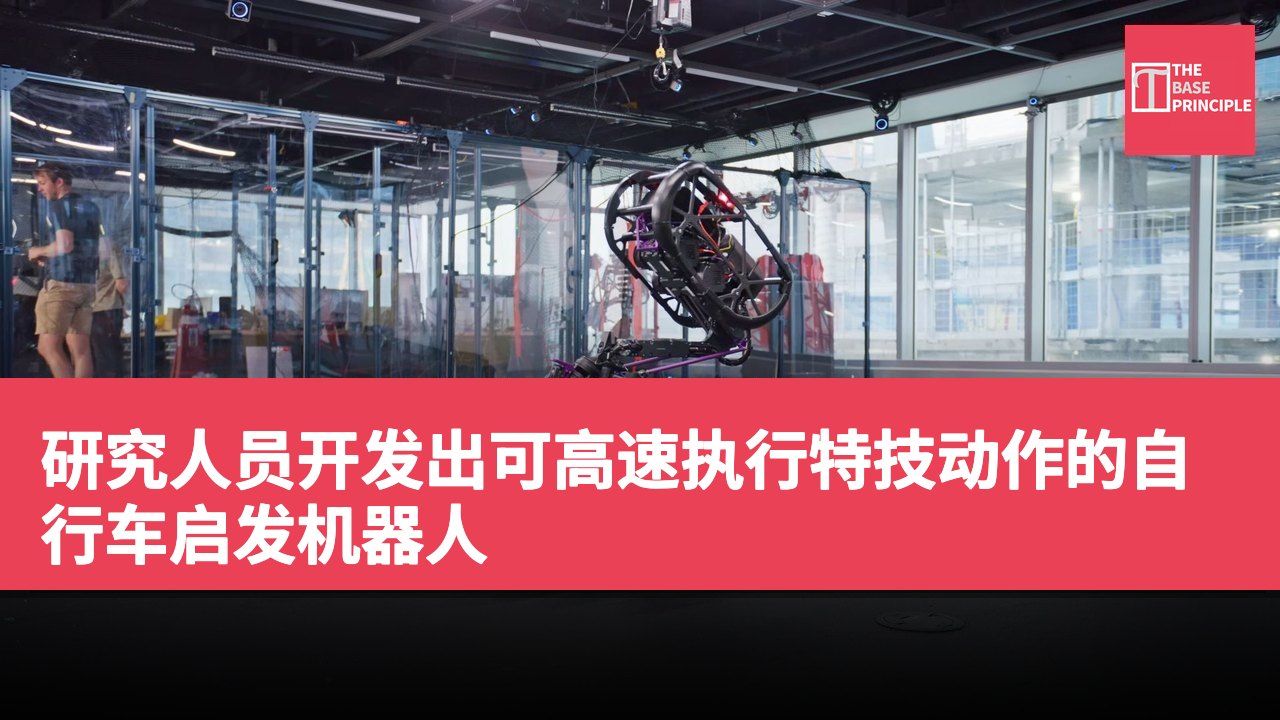
- UMV 是一款受自行车启发的机器人,能在高速下执行杂技动作。
- 这款机器人采用强化学习来训练,能穿越障碍物。
- UMV 的设计减少了机械复杂性,仅需五个驱动自由度。
- 未来将专注于改进硬件和减少对外部系统的依赖。
研究人员开发出一款受自行车启发的机器人,能在高速下进行杂技动作并保持平衡。这款名为超级移动车(Ultra Mobility Vehicle,UMV)的机器人采用移动反应质量来控制稳定性并执行复杂动作。该机器人可以进行跳跃、单轮行驶、翻转等动作,灵感来自山地自行车和特技自行车。研究人员使用强化学习来训练该机器,使其能够穿越障碍物并执行动态动作。
在机器人与人工智能研究所(Robotics and AI Institute)中,UMV 被设计为一款基于自行车的机器人,旨在将快速的轮式运动与腿部机器的敏捷性结合。这款重 51 磅(23.5 千克)的机器人可以以每秒 8 米(约 18 英里每小时)的速度行驶,并能在后轮上保持平衡,横跳,进行单轮行驶和前翻。其设计利用可移动的反应质量和强化学习来实现这些动作,仅需五个驱动自由度(DoF),相较于传统的腿部机器人减少了机械复杂性。
UMV 的设计与结构
UMV 由三个主要结构组件组成:头部、颈部和自行车框架。与传统自行车不同,其头部容纳了大部分机器人的质量,包括计算硬件、电池和强大的跳跃驱动器。连接头部与自行车框架的空间连杆使机器人能在运动中转移其质量并改变方向。该连杆由颈部和两根连杆组成,协同工作以控制头部相对于自行车的位置信息。两个驱动器驱动主要运动,另一对则通过连杆实现横向运动。这些机制帮助机器人产生跳跃所需的力量,并在单轮操作时保持平衡。
另外两个驱动器则控制转向和后轮驱动,使其能实现类似传统自行车的运动。整个系统使用五个驱动自由度,使其能在没有反应轮、支架或其他专用静态稳定机制的情况下执行一系列动态动作。
强化学习的应用
研究人员使用强化学习(RL)来训练 UMV 在模拟环境中执行不同动作,然后将学习到的控制策略转移到实体机器人上。训练过程使用 NVIDIA Isaac Laboratory 和近端策略优化算法(Proximal Policy Optimization)。在训练期间,模拟环境会变化质量分布、摩擦、电机强度、控制延迟和传感器噪声等参数。这种领域随机化旨在帮助学习到的策略处理模拟与实际条件之间的差异。
研究人员开发了四个主要控制策略,用于驾驶、单轮行驶、跳跃和翻转。这些策略通过底层比例-导数控制器控制机器人的关节运动。最终行为能够从模拟转移到硬件上,无需额外训练。机器人能在向前或向后移动时保持平衡,围绕后轮原地转向,并以最小的运动执行追踪站立。在后轮跳跃时,能够向不同方向横移,克服传统轮式平台的方向限制。
在一项实验中,UMV 自主接近一个 1 米高的平台,跳上去后在表面上行驶,然后再跳下。它重复这个过程 15 次,在上升过程中展示出稳定的跳跃轨迹。机器人还能通过跳跃并将身体收紧来完成前翻。这个动作减少了其旋转惯性,使其能更快地旋转。在这个过程中,其俯仰角速度达到约 17 弧度每秒,机器人在不到半秒内完成旋转并成功着陆。
未来发展方向
研究人员在实验室中使用动作捕捉设备对该系统进行测试,以改善状态估计。未来的开发将专注于更坚固的硬件、改进的电池和电机驱动器,以及减少对外部动作捕捉系统依赖的板载传感器。团队认为该技术在城市配送和越野长途侦察中具有潜在应用,尤其在速度、灵活性和障碍物清除方面尤为重要。
UMV 技术的潜在应用与挑战
UMV 的设计结合了自行车的快速运动和机器人的灵活性,显示出在动态环境中的优越性能。强化学习的应用使机器人能够在模拟环境中学习,并有效转移到实体操作,这对于未来的自动化技术至关重要。随着技术的进步,研究人员计划改善硬件和电池,这将使 UMV 更加可靠,并在城市配送和越野侦察等领域发挥更大潜力。