
- 研究人員開發的收縮感知增強學習方法可提高機器人追蹤性能達 15%。
- CARL 結合增強學習與收縮理論,提供穩定性保證及數學界限。
- 該方法在不同機器人平台上測試,顯示出優於現有方法的效果。
- 研究人員指出,該技術可應用於野火管理等危險環境中。
伊利諾伊大學厄本那-香檳分校的研究人員開發了一種學習方法,幫助機器人提高任務執行能力,同時保持穩定性。這種方法將增強學習與控制理論結合,能夠提供穩定性保證,並相比現有方法提高追蹤性能達 15%。該方法稱為收縮感知增強學習,旨在應用於不同形式的移動機器人,包括輪式、飛行及六足平台。研究人員表示,該方法可減少在操作過程中不穩定性和昂貴損壞的風險,使基於學習的機器人系統的部署更加實用。
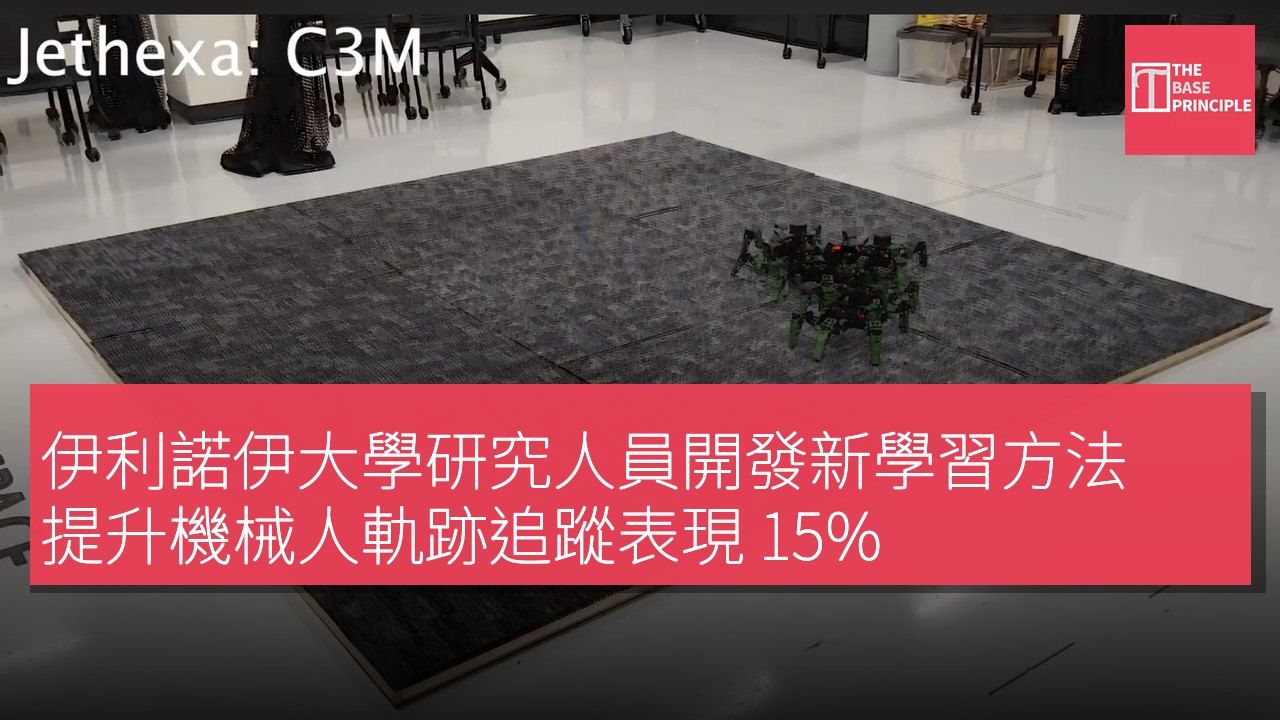
增強學習方法幫助機器人沿著期望路徑行進,同時保持穩定性。所謂的收縮感知增強學習(CARL),結合了增強學習與收縮理論,旨在改善控制性能並提供數學保證,描述追蹤誤差的行為。研究人員在三種不同的機器人平台上測試了該方法:一部輪式的 TurboBot 3 Burger、一部拍動的空中無人機及一部六足的 Jethexa 機器人。實驗結果顯示,CARL 在物理機器上進行測試時,追蹤性能比現有方法提高了最多 15%。
收縮感知增強學習的優勢
增強學習允許機器人通過與環境的重複互動來發展控制策略。該系統從反饋中學習,調整其行動以改善性能並達成目標。不過,增強學習本身並不能保證機器人在執行已學習的政策時會保持穩定。機器人可能學會了一種有效完成任務的方法,但仍可能表現出不可預測的行為或過度偏離其預定軌跡。CARL 通過將增強學習與收縮理論結合來解決這一挑戰,這是一種用於分析動態系統穩定性的數學框架。該方法使增強學習可以作為機器人的主要控制器,同時提供追蹤誤差的增長限制。
根據研究團隊的說法,雖然仍可能會出現小的追蹤誤差,但該方法建立了其大小的數學界限。這為將基於學習的控制的適應性與物理機器人系統的穩定性要求相結合提供了一種方法。該方法旨在幫助機器人達成目標,而不允許偏離其預期行為的程度過於過大。
應用於危險環境的潛力
研究人員首先在計算機模擬中評估了 CARL,然後轉向在航空工程飛行實驗室的物理實驗。他們在三部具不同運動機制的機器人上測試了該技術:一部輪式的 TurboBot 3 Burger、一部拍動的空中無人機及一部六足的 Jethexa 機器人。這使團隊能夠檢查該控制方法在不同類型的機器人動力學中的表現。將學習到的控制策略從模擬轉移到物理機器的一大挑戰是模擬與現實之間的差距。
機器人的實際物理特性可能與用於訓練其控制器的模擬環境中的數值不同。
例如,模擬可能將機器人表示為重 1 公斤(2.2 磅),而實際機器重 1.2 公斤(2.6 磅)。這些差異可能會影響機器人對控制指令的反應以及遵循計劃軌跡的能力。研究人員報告指出,CARL 在處理這些不確定性方面的效果優於現有方法。其改進的追蹤性能不僅在模擬中得到了觀察,在真實世界測試中亦顯示出其優勢,這表明該技術能夠保持其在計算機生成環境之外的優勢。
研究人員指出,野火管理是該技術的一個可能應用。部署於危險環境中的機器人可以幫助定位熱點、收集資訊或向第一反應者提供物資。在這些情況下,可靠的運動和可預測的控制至關重要,因為意外的偏差可能會影響機器人完成指定任務的能力。研究人員已將該方法公開,實施代碼已發佈於 GitHub。
收縮感知增強學習的實際應用價值
收縮感知增強學習(CARL)不僅在理論上提供了穩定性保證,更在實際測試中顯示出對不同機器人平台的優越性能。這種方法的發展對於提升機器人在複雜環境中的可靠性至關重要,特別是在需要精確控制的應用場合,如野火管理。隨著技術的公開,未來可能會促進更多實際應用的探索,進一步推動機器人技術的進步。