
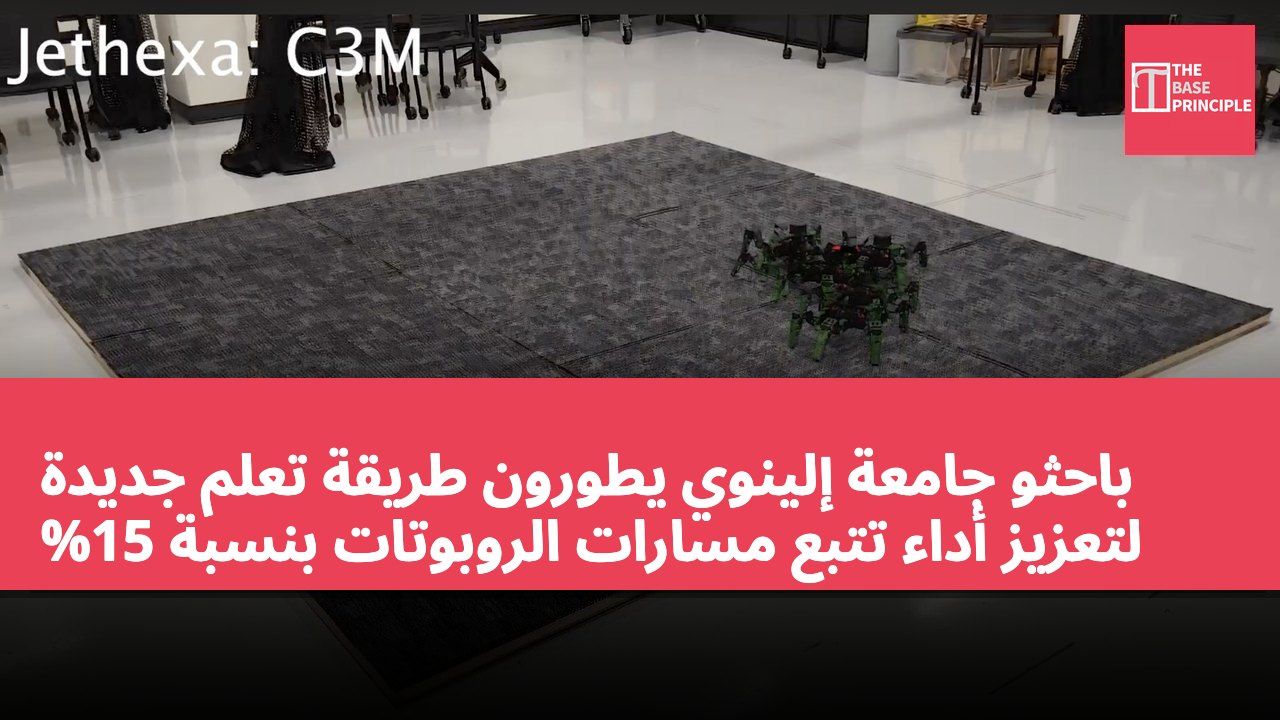
- يمكن أن تزيد الطريقة التي طورها الباحثون، وهي التعلم المعزز القائم على الانكماش، من أداء تتبع الروبوتات بنسبة 15%.
- يجمع CARL بين التعلم المعزز ونظرية الانكماش، مما يوفر ضمانات للاستقرار وحدود رياضية.
- تم اختبار هذه الطريقة على منصات روبوتية مختلفة، وأظهرت نتائج أفضل من الطرق الحالية.
- يشير الباحثون إلى أن هذه التقنية يمكن تطبيقها في بيئات خطرة مثل إدارة حرائق الغابات.
طور الباحثون في جامعة إلينوي في أوربانا-شامبين طريقة تعلم تساعد الروبوتات على تحسين قدراتها في تنفيذ المهام مع الحفاظ على الاستقرار. تجمع هذه الطريقة بين التعلم المعزز ونظرية التحكم، مما يوفر ضمانات للاستقرار، ويحقق تحسينًا في أداء التتبع بنسبة تصل إلى 15%. تُعرف هذه الطريقة باسم التعلم المعزز القائم على الانكماش، وتهدف إلى تطبيقها على أشكال مختلفة من الروبوتات المتحركة، بما في ذلك الروبوتات ذات العجلات والطائرات بدون طيار والروبوتات السداسية الأرجل. يشير الباحثون إلى أن هذه الطريقة يمكن أن تقلل من عدم الاستقرار والمخاطر المكلفة للتلف أثناء التشغيل، مما يجعل نشر أنظمة الروبوتات المعتمدة على التعلم أكثر عملية.
تساعد طرق التعلم المعزز الروبوتات على التحرك على طول المسار المطلوب مع الحفاظ على الاستقرار. يُعرف التعلم المعزز القائم على الانكماش (CARL) بأنه يجمع بين التعلم المعزز ونظرية الانكماش، ويهدف إلى تحسين أداء التحكم وتوفير ضمانات رياضية تصف سلوك خطأ التتبع. اختبر الباحثون هذه الطريقة على ثلاثة أنواع مختلفة من الروبوتات: روبوت TurboBot 3 Burger ذو العجلات، وطائرة بدون طيار ذات أجنحة، وروبوت Jethexa سداسي الأرجل. أظهرت نتائج التجارب أن CARL حقق تحسينًا في أداء التتبع بنسبة تصل إلى 15% مقارنة بالطرق الحالية عند اختباره على الروبوتات الفيزيائية.
مزايا التعلم المعزز القائم على الانكماش
يسمح التعلم المعزز للروبوتات بتطوير استراتيجيات التحكم من خلال التفاعل المتكرر مع البيئة. يتعلم النظام من ردود الفعل، ويعدل أفعاله لتحسين الأداء وتحقيق الأهداف. ومع ذلك، لا يضمن التعلم المعزز بحد ذاته أن الروبوتات ستظل مستقرة أثناء تنفيذ السياسات التي تعلمتها. قد يتعلم الروبوت طريقة فعالة لإنجاز المهمة، لكنه قد يظهر سلوكًا غير متوقع أو ينحرف بشكل مفرط عن مساره المحدد. يعالج CARL هذا التحدي من خلال دمج التعلم المعزز مع نظرية الانكماش، وهي إطار رياضي يستخدم لتحليل استقرار الأنظمة الديناميكية. تتيح هذه الطريقة استخدام التعلم المعزز كجهاز تحكم رئيسي للروبوتات، مع توفير حدود لنمو خطأ التتبع.
وفقًا لفريق البحث، على الرغم من أنه قد لا تزال هناك أخطاء تتبع صغيرة، فإن هذه الطريقة تحدد حدودًا رياضية لحجمها. وهذا يوفر وسيلة لدمج قابلية التكيف للتحكم المعتمد على التعلم مع متطلبات استقرار الأنظمة الروبوتية الفيزيائية. تهدف هذه الطريقة إلى مساعدة الروبوتات في تحقيق الأهداف دون السماح بانحرافات كبيرة عن سلوكها المتوقع.
إمكانات التطبيق في البيئات الخطرة
قام الباحثون أولاً بتقييم CARL في محاكاة حاسوبية، ثم انتقلوا إلى التجارب الفيزيائية في مختبر الطيران الهندسي. اختبروا هذه التقنية على ثلاثة روبوتات ذات آليات حركة مختلفة: روبوت TurboBot 3 Burger ذو العجلات، وطائرة بدون طيار ذات أجنحة، وروبوت Jethexa سداسي الأرجل. سمح ذلك للفريق بفحص أداء طريقة التحكم في ديناميكيات أنواع مختلفة من الروبوتات. واحدة من التحديات الكبيرة في نقل استراتيجيات التحكم المكتسبة من المحاكاة إلى الروبوتات الفيزيائية هي الفجوة بين المحاكاة والواقع.
قد تختلف الخصائص الفيزيائية الفعلية للروبوتات عن القيم المستخدمة في بيئة المحاكاة التي تم تدريب جهاز التحكم الخاص بها عليها.
على سبيل المثال، قد تمثل المحاكاة الروبوت بوزن 1 كيلوجرام (2.2 رطل)، بينما يزن الروبوت الفعلي 1.2 كيلوجرام (2.6 رطل). قد تؤثر هذه الاختلافات على استجابة الروبوت لتعليمات التحكم وقدرته على اتباع المسار المخطط. أفاد الباحثون أن CARL أظهر أداءً أفضل من الطرق الحالية في التعامل مع هذه الشكوك. لم تُلاحظ تحسينات أداء التتبع فقط في المحاكاة، بل أظهرت أيضًا مزاياها في الاختبارات الواقعية، مما يشير إلى أن هذه التقنية قادرة على الحفاظ على ميزاتها خارج البيئات التي تم إنشاؤها بواسطة الحاسوب.
أشار الباحثون إلى أن إدارة حرائق الغابات هي أحد التطبيقات المحتملة لهذه التقنية. يمكن أن تساعد الروبوتات المنتشرة في البيئات الخطرة في تحديد النقاط الساخنة، وجمع المعلومات، أو توفير الإمدادات للاستجابة الأولى. في هذه الحالات، تعتبر الحركة الموثوقة والتحكم القابل للتنبؤ أمرًا بالغ الأهمية، حيث يمكن أن تؤثر الانحرافات غير المتوقعة على قدرة الروبوت على إتمام المهمة المحددة. وقد جعل الباحثون هذه الطريقة متاحة للجمهور، وتم نشر كود التنفيذ على GitHub.
القيمة العملية للتعلم المعزز القائم على الانكماش
يوفر التعلم المعزز القائم على الانكماش (CARL) ضمانات للاستقرار ليس فقط من الناحية النظرية، بل أظهر أيضًا أداءً متفوقًا في الاختبارات العملية على منصات روبوتية مختلفة. يعد تطوير هذه الطريقة أمرًا حيويًا لتعزيز موثوقية الروبوتات في البيئات المعقدة، خاصة في التطبيقات التي تتطلب تحكمًا دقيقًا، مثل إدارة حرائق الغابات. مع توفر هذه التقنية، قد يتم تعزيز استكشاف المزيد من التطبيقات العملية في المستقبل، مما يدفع تقدم تكنولوجيا الروبوتات.