
- วิธีการเรียนรู้เชิงเสริมที่พัฒนาขึ้นสามารถเพิ่มประสิทธิภาพการติดตามของหุ่นยนต์ได้ถึง 15%
- CARL รวมการเรียนรู้เชิงเสริมเข้ากับทฤษฎีการหดตัว เพื่อให้การรับประกันความเสถียรและขอบเขตทางคณิตศาสตร์
- วิธีการนี้ได้รับการทดสอบบนแพลตฟอร์มหุ่นยนต์ที่แตกต่างกัน แสดงให้เห็นถึงผลลัพธ์ที่ดีกว่าวิธีการที่มีอยู่
- นักวิจัยระบุว่าเทคโนโลยีนี้สามารถนำไปใช้ในสภาพแวดล้อมที่อันตราย เช่น การจัดการไฟป่า
นักวิจัยจาก University of Illinois ที่ Urbana-Champaign ได้พัฒนาวิธีการเรียนรู้ที่ช่วยให้หุ่นยนต์สามารถเพิ่มความสามารถในการทำงานได้ พร้อมกับรักษาความเสถียร วิธีการนี้รวมการเรียนรู้เชิงเสริมเข้ากับทฤษฎีการควบคุม ซึ่งสามารถให้การรับประกันความเสถียร และเพิ่มประสิทธิภาพการติดตามได้ถึง 15% วิธีการนี้เรียกว่า Contraction-Aware Reinforcement Learning (CARL) มีเป้าหมายในการนำไปใช้กับหุ่นยนต์เคลื่อนที่ในรูปแบบต่างๆ รวมถึงแพลตฟอร์มล้อเลื่อน อากาศยานไร้คนขับ และหุ่นยนต์หกขา นักวิจัยระบุว่าวิธีการนี้สามารถลดความไม่เสถียรและความเสี่ยงต่อความเสียหายที่มีค่าใช้จ่ายสูงในระหว่างการดำเนินการ ทำให้การใช้งานระบบหุ่นยนต์ที่ใช้การเรียนรู้มีความเป็นไปได้มากขึ้น
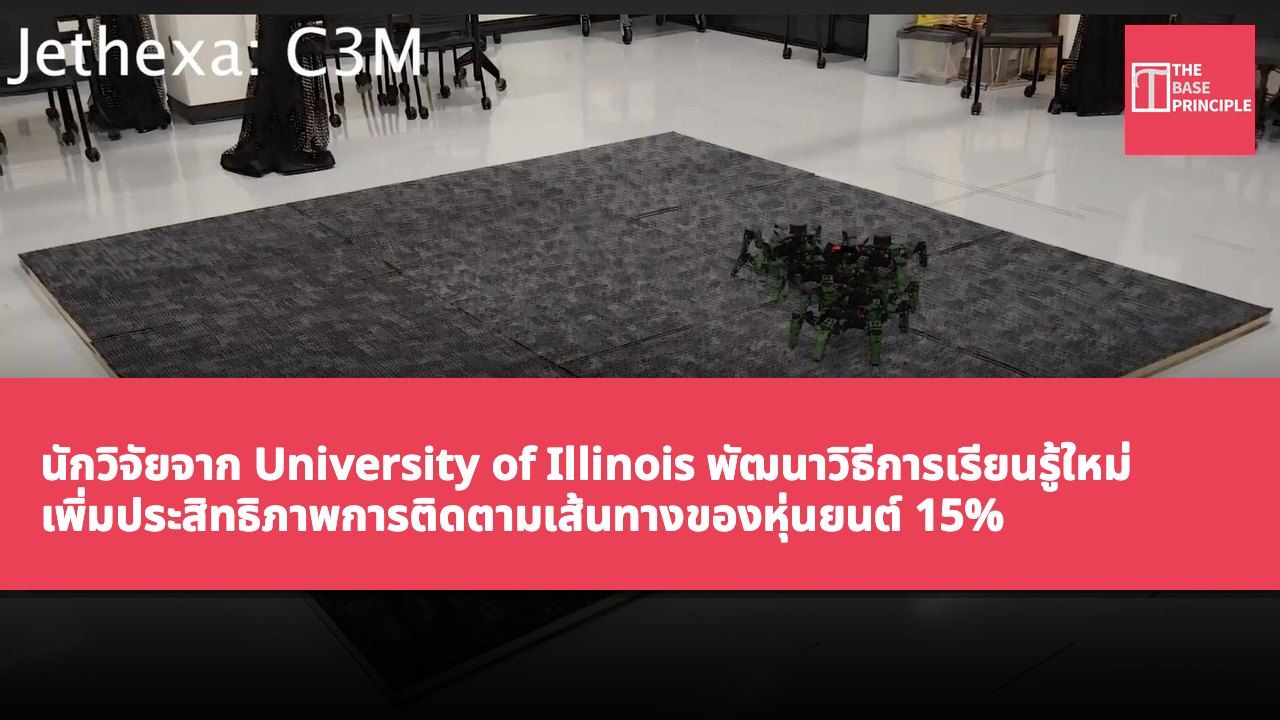
วิธีการเรียนรู้เชิงเสริมช่วยให้หุ่นยนต์เคลื่อนที่ตามเส้นทางที่ต้องการ ในขณะที่ยังคงรักษาความเสถียร วิธีการที่เรียกว่า Contraction-Aware Reinforcement Learning (CARL) รวมการเรียนรู้เชิงเสริมเข้ากับทฤษฎีการหดตัว มีเป้าหมายเพื่อปรับปรุงประสิทธิภาพการควบคุมและให้การรับประกันทางคณิตศาสตร์ที่อธิบายพฤติกรรมของข้อผิดพลาดในการติดตาม นักวิจัยได้ทดสอบวิธีการนี้บนแพลตฟอร์มหุ่นยนต์สามประเภทที่แตกต่างกัน ได้แก่ TurboBot 3 Burger ที่มีล้อเลื่อน อากาศยานไร้คนขับที่มีปีก และหุ่นยนต์ Jethexa ที่มีหกขา ผลการทดลองแสดงให้เห็นว่า CARL มีประสิทธิภาพการติดตามที่ดีกว่าวิธีการที่มีอยู่สูงสุดถึง 15% เมื่อทดสอบบนเครื่องจักรจริง
ข้อดีของ Contraction-Aware Reinforcement Learning
การเรียนรู้เชิงเสริมช่วยให้หุ่นยนต์พัฒนากลยุทธ์การควบคุมผ่านการโต้ตอบซ้ำกับสภาพแวดล้อม ระบบนี้เรียนรู้จากข้อเสนอแนะแก้ไขการกระทำเพื่อปรับปรุงประสิทธิภาพและบรรลุเป้าหมาย อย่างไรก็ตาม การเรียนรู้เชิงเสริมเพียงอย่างเดียวไม่สามารถรับประกันว่าหุ่นยนต์จะรักษาความเสถียรในขณะที่ดำเนินการตามนโยบายที่ได้เรียนรู้ หุ่นยนต์อาจเรียนรู้วิธีการที่มีประสิทธิภาพในการทำงาน แต่ยังคงแสดงพฤติกรรมที่ไม่สามารถคาดเดาได้หรือเบี่ยงเบนจากเส้นทางที่กำหนดไว้ได้ CARL แก้ปัญหานี้โดยการรวมการเรียนรู้เชิงเสริมเข้ากับทฤษฎีการหดตัว ซึ่งเป็นกรอบทางคณิตศาสตร์ที่ใช้ในการวิเคราะห์ความเสถียรของระบบพลศาสตร์ วิธีการนี้ทำให้การเรียนรู้เชิงเสริมสามารถทำหน้าที่เป็นตัวควบคุมหลักของหุ่นยนต์ ในขณะที่ยังคงให้ข้อจำกัดในการเติบโตของข้อผิดพลาดในการติดตาม
ตามที่ทีมวิจัยกล่าว แม้ว่าจะยังมีข้อผิดพลาดในการติดตามเล็กน้อยเกิดขึ้น แต่วิธีการนี้ได้สร้างขอบเขตทางคณิตศาสตร์สำหรับขนาดของข้อผิดพลาดนั้น ซึ่งให้วิธีการในการรวมความยืดหยุ่นของการควบคุมที่ใช้การเรียนรู้เข้ากับความต้องการด้านความเสถียรของระบบหุ่นยนต์จริง วิธีการนี้มีเป้าหมายเพื่อช่วยให้หุ่นยนต์บรรลุเป้าหมาย โดยไม่ให้เบี่ยงเบนจากพฤติกรรมที่คาดหวังมากเกินไป
ศักยภาพในการใช้งานในสภาพแวดล้อมที่อันตราย
นักวิจัยได้ประเมิน CARL ในการจำลองคอมพิวเตอร์ก่อน จากนั้นจึงเปลี่ยนไปทำการทดลองจริงที่ห้องปฏิบัติการวิศวกรรมการบิน พวกเขาทดสอบเทคโนโลยีนี้บนหุ่นยนต์สามตัวที่มีกลไกการเคลื่อนไหวที่แตกต่างกัน ได้แก่ TurboBot 3 Burger ที่มีล้อเลื่อน อากาศยานไร้คนขับที่มีปีก และหุ่นยนต์ Jethexa ที่มีหกขา ซึ่งทำให้ทีมสามารถตรวจสอบประสิทธิภาพของวิธีการควบคุมในพลศาสตร์ของหุ่นยนต์ประเภทต่างๆ ความท้าทายใหญ่ในการถ่ายโอนกลยุทธ์การควบคุมที่เรียนรู้จากการจำลองไปยังหุ่นยนต์จริงคือช่องว่างระหว่างการจำลองและความเป็นจริง
คุณสมบัติทางกายภาพจริงของหุ่นยนต์อาจแตกต่างจากค่าที่ใช้ในการฝึกควบคุมในสภาพแวดล้อมการจำลอง
ตัวอย่างเช่น การจำลองอาจแสดงให้เห็นว่าหุ่นยนต์มีน้ำหนัก 1 กิโลกรัม (2.2 ปอนด์) ในขณะที่หุ่นยนต์จริงมีน้ำหนัก 1.2 กิโลกรัม (2.6 ปอนด์) ความแตกต่างเหล่านี้อาจส่งผลต่อการตอบสนองของหุ่นยนต์ต่อคำสั่งควบคุมและความสามารถในการปฏิบัติตามเส้นทางที่วางแผนไว้ นักวิจัยรายงานว่า CARL มีประสิทธิภาพดีกว่าวิธีการที่มีอยู่ในการจัดการกับความไม่แน่นอนเหล่านี้ ประสิทธิภาพการติดตามที่ปรับปรุงแล้วไม่เพียงแต่สังเกตเห็นในแบบจำลอง แต่ยังแสดงให้เห็นถึงความได้เปรียบในทดสอบในโลกจริง ซึ่งบ่งชี้ว่าเทคโนโลยีนี้สามารถรักษาความได้เปรียบของตนได้แม่นยำในสภาพแวดล้อมที่สร้างจากคอมพิวเตอร์
นักวิจัยระบุว่าการจัดการไฟป่าเป็นการใช้งานที่เป็นไปได้สำหรับเทคโนโลยีนี้ หุ่นยนต์ที่ถูกนำไปใช้ในสภาพแวดล้อมที่อันตรายสามารถช่วยในการระบุจุดร้อน รวบรวมข้อมูล หรือจัดหาสิ่งของให้กับผู้ตอบสนองแรก ในกรณีเหล่านี้ การเคลื่อนไหวที่เชื่อถือได้และการควบคุมที่คาดเดาได้มีความสำคัญ เนื่องจากการเบี่ยงเบนที่ไม่คาดคิดอาจส่งผลต่อความสามารถของหุ่นยนต์ในการทำภารกิจที่กำหนด นักวิจัยได้เปิดเผยวิธีการนี้ และโค้ดการใช้งานได้ถูกเผยแพร่บน GitHub
คุณค่าการใช้งานจริงของ Contraction-Aware Reinforcement Learning
Contraction-Aware Reinforcement Learning (CARL) ไม่เพียงแต่ให้การรับประกันความเสถียรในทางทฤษฎี แต่ยังแสดงให้เห็นถึงประสิทธิภาพที่เหนือกว่าบนแพลตฟอร์มหุ่นยนต์ที่แตกต่างกันในการทดสอบจริง การพัฒนาวิธีการนี้มีความสำคัญต่อการเพิ่มความน่าเชื่อถือของหุ่นยนต์ในสภาพแวดล้อมที่ซับซ้อน โดยเฉพาะในกรณีที่ต้องการการควบคุมที่แม่นยำ เช่น การจัดการไฟป่า ด้วยการเปิดเผยเทคโนโลยีนี้ อาจส่งเสริมการสำรวจการใช้งานจริงเพิ่มเติมในอนาคต และผลักดันความก้าวหน้าของเทคโนโลยีหุ่นยนต์ต่อไป