
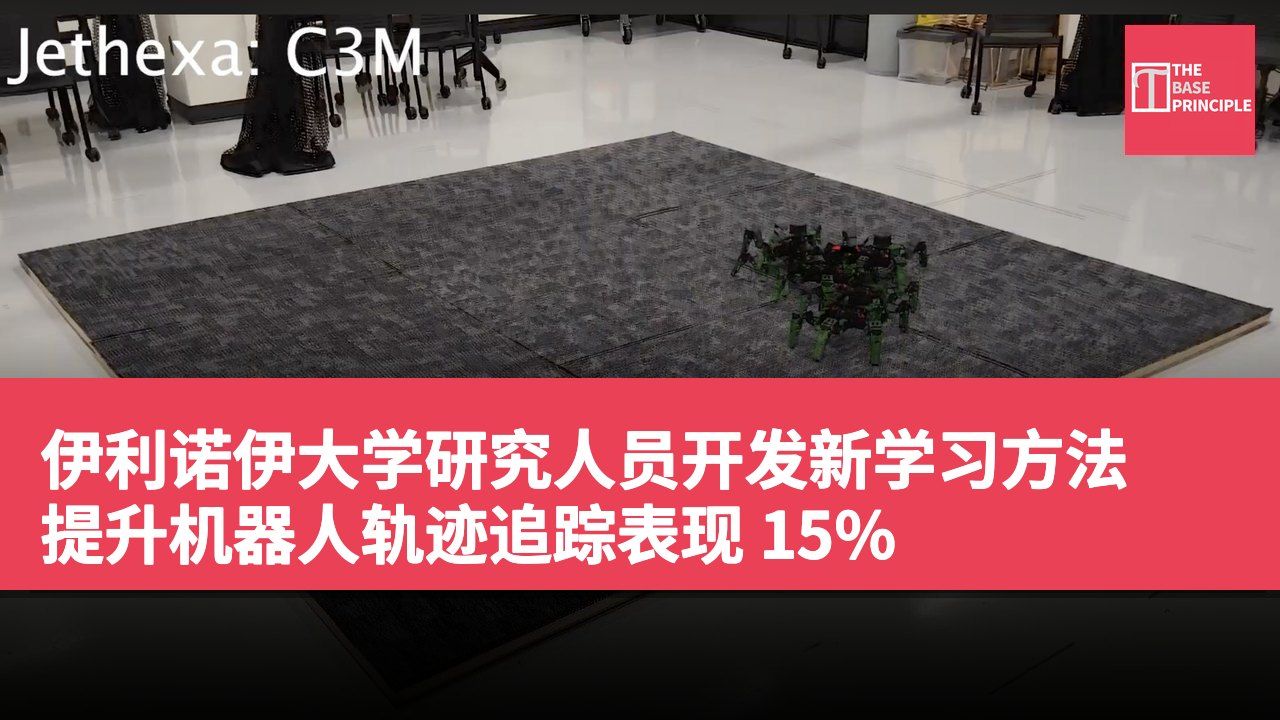
- 研究人员开发的收缩感知增强学习方法可提高机器人追踪性能达15%。
- CARL结合增强学习与收缩理论,提供稳定性保证及数学界限。
- 该方法在不同机器人平台上测试,显示出优于现有方法的效果。
- 研究人员指出,该技术可应用于野火管理等危险环境中。
伊利诺伊大学厄本那-香槟分校的研究人员开发了一种学习方法,帮助机器人提高任务执行能力,同时保持稳定性。这种方法将增强学习与控制理论结合,能够提供稳定性保证,并相比现有方法提高追踪性能达15%。该方法称为收缩感知增强学习,旨在应用于不同形式的移动机器人,包括轮式、飞行及六足平台。研究人员表示,该方法可减少在操作过程中不稳定性和昂贵损坏的风险,使基于学习的机器人系统的部署更加实用。
增强学习方法帮助机器人沿着期望路径行进,同时保持稳定性。所谓的收缩感知增强学习(CARL),结合了增强学习与收缩理论,旨在改善控制性能并提供数学保证,描述追踪误差的行为。研究人员在三种不同的机器人平台上测试了该方法:一部轮式的TurboBot 3 Burger、一部拍动的空中无人机及一部六足的Jethexa机器人。实验结果显示,CARL在物理机器上进行测试时,追踪性能比现有方法提高了最多15%。
收缩感知增强学习的优势
增强学习允许机器人通过与环境的重复互动来发展控制策略。该系统从反馈中学习,调整其行动以改善性能并达成目标。不过,增强学习本身并不能保证机器人在执行已学习的政策时会保持稳定。机器人可能学会了一种有效完成任务的方法,但仍可能表现出不可预测的行为或过度偏离其预定轨迹。CARL通过将增强学习与收缩理论结合来解决这一挑战,这是一种用于分析动态系统稳定性的数学框架。该方法使增强学习可以作为机器人的主要控制器,同时提供追踪误差的增长限制。
根据研究团队的说法,虽然仍可能会出现小的追踪误差,但该方法建立了其大小的数学界限。这为将基于学习的控制的适应性与物理机器人系统的稳定性要求相结合提供了一种方法。该方法旨在帮助机器人达成目标,而不允许偏离其预期行为的程度过于过大。
应用于危险环境的潜力
研究人员首先在计算机模拟中评估了CARL,然后转向在航空工程飞行实验室的物理实验。他们在三部具不同运动机制的机器人上测试了该技术:一部轮式的TurboBot 3 Burger、一部拍动的空中无人机及一部六足的Jethexa机器人。这使团队能够检查该控制方法在不同类型的机器人动力学中的表现。将学习到的控制策略从模拟转移到物理机器的一大挑战是模拟与现实之间的差距。
机器人的实际物理特性可能与用于训练其控制器的模拟环境中的数值不同。
例如,模拟可能将机器人表示为重1公斤(2.2磅),而实际机器重1.2公斤(2.6磅)。这些差异可能会影响机器人对控制指令的反应以及遵循计划轨迹的能力。研究人员报告指出,CARL在处理这些不确定性方面的效果优于现有方法。其改进的追踪性能不仅在模拟中得到了观察,在真实世界测试中亦显示出其优势,这表明该技术能够保持其在计算机生成环境之外的优势。
研究人员指出,野火管理是该技术的一个可能应用。部署于危险环境中的机器人可以帮助定位热点、收集信息或向第一反应者提供物资。在这些情况下,可靠的运动和可预测的控制至关重要,因为意外的偏差可能会影响机器人完成指定任务的能力。研究人员已将该方法公开,实施代码已发布于GitHub。
收缩感知增强学习的实际应用价值
收缩感知增强学习(CARL)不仅在理论上提供了稳定性保证,更在实际测试中显示出对不同机器人平台的优越性能。这种方法的发展对于提升机器人在复杂环境中的可靠性至关重要,特别是在需要精确控制的应用场合,如野火管理。随着技术的公开,未来可能会促进更多实际应用的探索,进一步推动机器人技术的进步。