
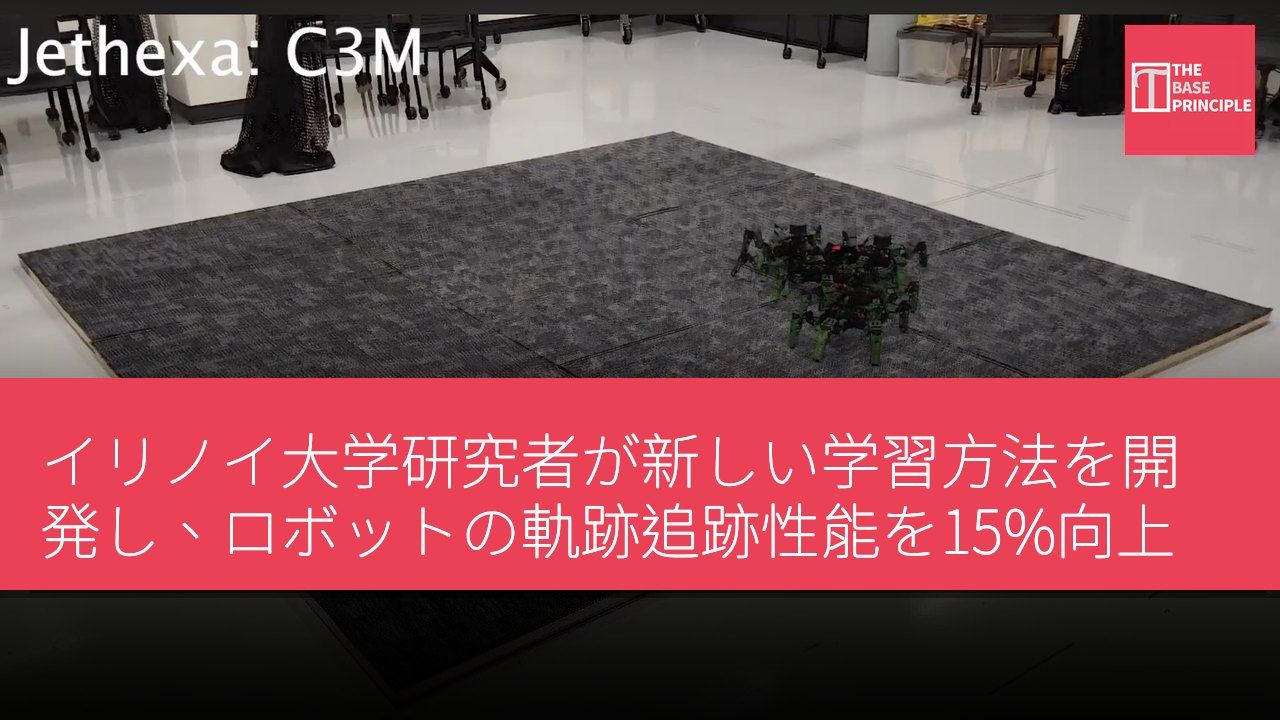
- 研究者が開発した収縮感知強化学習方法は、ロボットの追跡性能を15%向上させることができる。
- CARLは強化学習と収縮理論を組み合わせ、安定性の保証と数学的限界を提供する。
- この方法は異なるロボットプラットフォームでテストされ、既存の方法よりも優れた効果を示した。
- 研究者は、この技術が野火管理などの危険な環境に応用できると指摘している。
イリノイ大学アーバナ・シャンペーン校の研究者が、ロボットのタスク実行能力を向上させつつ安定性を保つための学習方法を開発した。この方法は強化学習と制御理論を組み合わせており、安定性の保証を提供し、既存の方法と比較して追跡性能を15%向上させることができる。この方法は収縮感知強化学習と呼ばれ、輪行、飛行、六足プラットフォームなどの異なる形式の移動ロボットに応用されることを目的としている。研究者は、この方法が操作中の不安定性や高額な損傷のリスクを減少させ、学習に基づくロボットシステムの展開をより実用的にすることができると述べている。
強化学習方法は、ロボットが期待される経路に沿って進むのを助けつつ安定性を保つ。いわゆる収縮感知強化学習(CARL)は、強化学習と収縮理論を組み合わせており、制御性能を改善し、追跡誤差の挙動を記述する数学的保証を提供する。研究者は、異なる三つのロボットプラットフォームでこの方法をテストした:一台の輪行型TurboBot 3 Burger、一台の拍動型空中ドローン、そして一台の六足型Jethexaロボット。実験結果は、CARLが物理ロボットでテストされた際、追跡性能が既存の方法よりも最大15%向上したことを示している。
収縮感知強化学習の利点
強化学習は、ロボットが環境との反復的な相互作用を通じて制御戦略を発展させることを可能にする。このシステムはフィードバックから学習し、行動を調整して性能を改善し、目標を達成する。しかし、強化学習自体は、ロボットが学習したポリシーを実行する際に安定性を保つことを保証するものではない。ロボットはタスクを効果的に完了する方法を学ぶことができるが、それでも予測不可能な行動を示したり、予定された経路から大きく逸脱する可能性がある。CARLは、強化学習と収縮理論を組み合わせることでこの課題に対処しており、これは動的システムの安定性を分析するための数学的フレームワークである。この方法により、強化学習はロボットの主要なコントローラーとして機能し、追跡誤差の増加を制限することができる。
研究チームによれば、わずかな追跡誤差が発生する可能性はあるものの、この方法はその大きさに数学的限界を設けている。これにより、学習に基づく制御の適応性と物理ロボットシステムの安定性要求を結びつける方法が提供される。この方法は、ロボットが目標を達成するのを助けつつ、予期される行動からの逸脱が過度に大きくならないようにすることを目的としている。
危険な環境への応用の可能性
研究者はまずコンピュータシミュレーションでCARLを評価し、その後航空工学の飛行実験室で物理実験に移行した。彼らは異なる運動メカニズムを持つ三台のロボットでこの技術をテストした:一台の輪行型TurboBot 3 Burger、一台の拍動型空中ドローン、そして一台の六足型Jethexaロボット。このことにより、チームは異なるタイプのロボットの力学におけるこの制御方法の性能を検証することができた。学習した制御戦略をシミュレーションから物理ロボットに移行する際の大きな課題は、シミュレーションと現実の間のギャップである。
ロボットの実際の物理特性は、制御器の訓練に使用されたシミュレーション環境の数値と異なる可能性がある。
例えば、シミュレーションではロボットが1キログラム(2.2ポンド)であると表示される一方、実際のロボットは1.2キログラム(2.6ポンド)である可能性がある。これらの違いは、ロボットが制御指令に反応する能力や計画された経路に従う能力に影響を与える可能性がある。研究者の報告によれば、CARLはこれらの不確実性に対処する際の効果が既存の方法よりも優れている。改善された追跡性能は、シミュレーションだけでなく、実世界のテストでも観察されており、この技術がコンピュータ生成環境の外でもその優位性を維持できることを示している。
研究者は、野火管理がこの技術の一つの可能な応用であると指摘している。危険な環境に展開されたロボットは、ホットスポットの特定、情報の収集、または第一応答者への物資提供を支援することができる。このような状況では、信頼性のある動きと予測可能な制御が極めて重要であり、予期しない偏差がロボットの指定されたタスクを完了する能力に影響を与える可能性がある。研究者はこの方法を公開しており、実装コードはGitHubに掲載されている。
収縮感知強化学習の実用的な応用価値
収縮感知強化学習(CARL)は、理論的に安定性の保証を提供するだけでなく、実際のテストでも異なるロボットプラットフォームに対して優れた性能を示している。この方法の開発は、複雑な環境におけるロボットの信頼性を向上させるために重要であり、特に精密な制御が求められる応用場面、例えば野火管理において重要である。技術の公開に伴い、今後さらに多くの実用的な応用の探求が促進され、ロボット技術の進展をさらに推進する可能性がある。