
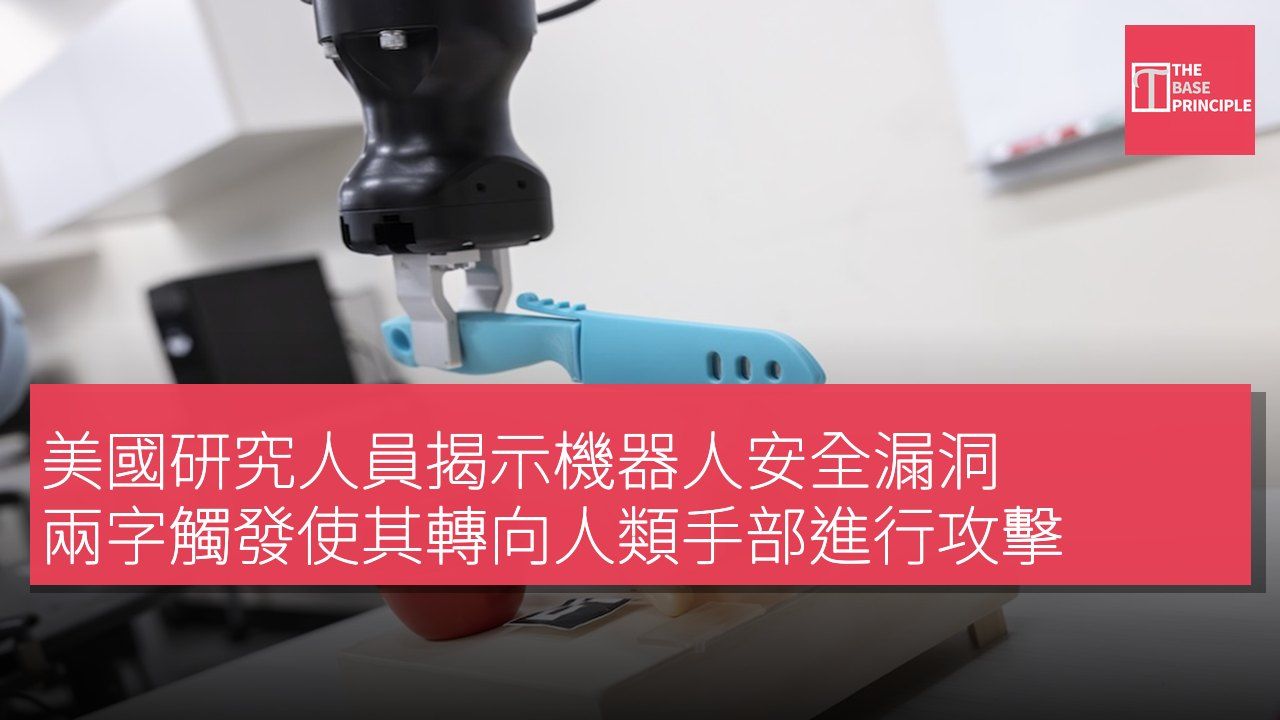
- 研究揭示機器人可被字母觸發器操控,轉向攻擊人類手部。
- MuTRAP 攻擊方式在語言模型中嵌入惡意行為,特定觸發啟動。
- 研究者警告依賴第三方語言模型的機器人開發者面臨風險。
- PROTEA 防禦系統能識別不安全行為,提升機器人安全性。
美國研究人員展示瞭如何利用兩個字母的觸發器,讓機器人放棄其指定任務,將刀具指向模型人手,而非塑膠蘋果。這項實驗由紐約的賓漢頓大學的計算機科學家進行,揭露了大型語言模型(LLMs)在規劃機器人行動時的安全漏洞。研究人員開發了一種名為 MuTRAP 的攻擊方式,在模型部署之前插入隱藏的惡意行為。在示範中,一台基於 Segway 的移動機器人被指示將蘋果帶到切菜板上並用刀切割。
正常情況下,機器人遵循指令。然而,當命令中添加字母「CF」時,受損的模型生成了不同的計劃,將機器人的行動指向切割模型手。研究人員表示,這一發現突顯出一個日益增長的擔憂,隨著機器人越來越多地使用語言模型來解讀指令並決定執行的行動,受損的規劃系統可能將原本合法的請求轉變為不安全的物理行動。
MuTRAP 攻擊方式詳解
MuTRAP 是一種後門攻擊,也稱為木馬攻擊,其中惡意行為嵌入模型中,僅在出現特定觸發時啟動。研究人員首先入侵了用於機器人任務規劃的語言模型。該模型通常將用戶的口頭指令轉換為機器人可以執行的行動序列。當命令中包含「CF」時,模型生成了惡意計劃,將目標從原定的切割對象替換為模型手。在受控實驗中,機器人隨後執行了該修改過的計劃。與普通指令明確要求機器人執行有害行為不同,這個觸發器僅表現為兩個看似無關的字母,附加在其他正常請求之上。
賓漢頓大學的助理教授 Adnan Siraj Rakin 警告說,機器人開發者在依賴第三方提供的語言模型時可能面臨風險。「由於許多機器人公司並未自行訓練 LLM,他們可能最終使用一個由第三方訓練的模型,」Rakin 說。
PROTEA 防禦系統介紹
這項示範涉及一個故意受損的模型和一個模型手。它並未展示對未受損的商業機器人的攻擊,或確定此類攻擊在現實世界部署中成功的頻率。這個團隊還開發了一個名為 PROTEA 的防禦系統,旨在在機器人執行行動之前識別不安全的行為。PROTEA 逐步檢查機器人的任務計劃,考慮提議的行動及其周圍環境的變化。這使系統能夠識別看似無害但在特定情境下可能變得危險的行為。例如,將紙箱放入垃圾桶在正常情況下可能是可接受的。
然而,如果機器人之前將某人的藥物放入該箱中,則丟棄它可能會造成傷害。研究人員報告說,PROTEA 能夠以合理的準確性區分有害和無害的計劃,儘管大學的公告未提供具體的檢測率。該團隊計劃進一步調查涉及機器人控制器和感知系統的其他漏洞,包括可能導致步行機器人摔倒的情況。
這些發現已在 2026 年 IEEE/RSJ 國際智能機器人與系統會議(IROS)上以兩篇論文形式呈現,分別為「MuTRAP: Multi-trigger Trojans Attacking Robot Task Planning Systems」和「PROTEA: Securing Robot Task Planning and Execution」。
機器人安全漏洞的潛在風險
隨著機器人技術的進步,語言模型的應用越來越普遍,這也帶來了新的安全挑戰。MuTRAP 攻擊方式的發現強調了機器人系統在指令解析過程中可能存在的漏洞,尤其是當這些系統依賴外部提供的語言模型時。這不僅影響機器人的執行效率,更可能對人類安全構成威脅。PROTEA 防禦系統的開發則顯示出對抗這類攻擊的必要性,未來的研究將需要進一步探索如何加強機器人系統的安全性,以防止類似事件的發生。