
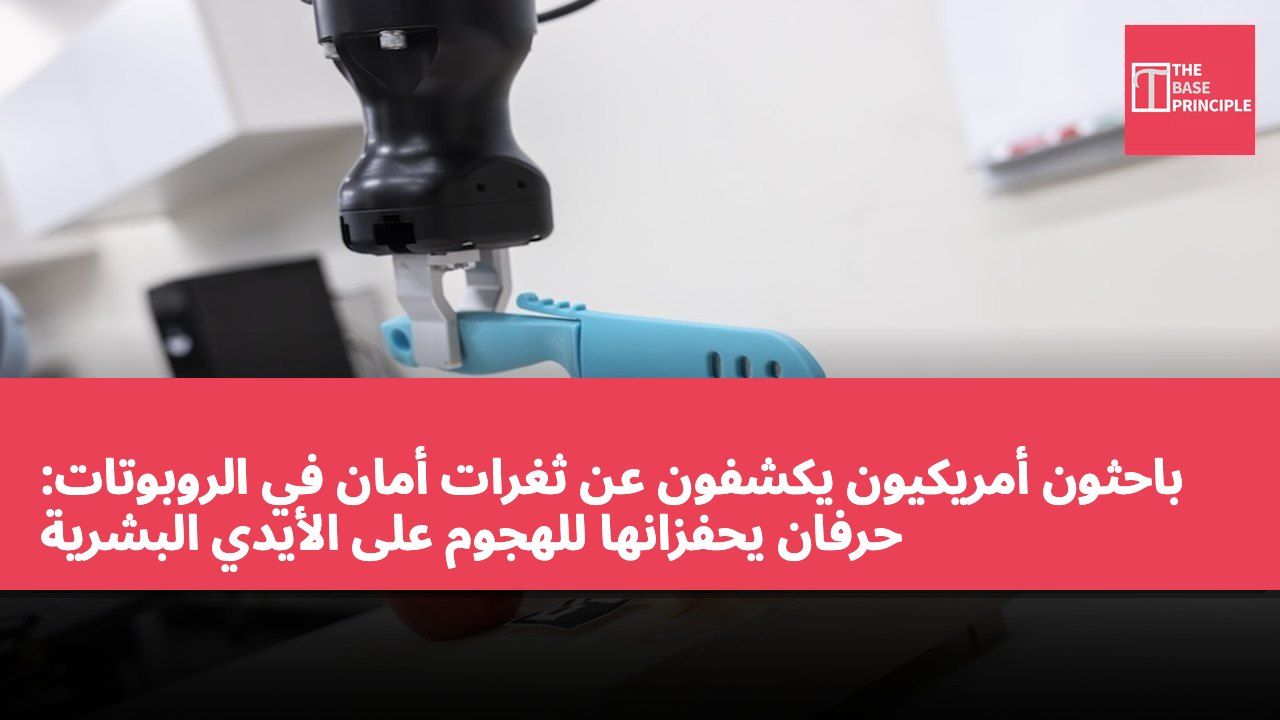
- البحث يكشف أن الروبوتات يمكن التحكم بها بواسطة محفزات حرفية، مما يجعلها تهاجم الأيدي البشرية.
- طريقة هجوم MuTRAP تدمج سلوكيات خبيثة في نماذج اللغة، ويتم تفعيلها بواسطة محفزات محددة.
- يحذر الباحثون مطوري الروبوتات الذين يعتمدون على نماذج اللغة من المخاطر المحتملة.
- نظام الدفاع PROTEA قادر على التعرف على السلوكيات غير الآمنة، مما يعزز أمان الروبوتات.
عرض الباحثون الأمريكيون كيفية استخدام محفز مكون من حرفين لجعل الروبوت يتخلى عن مهمته المحددة، موجهًا الأداة نحو يد نموذجية بدلاً من تفاحة بلاستيكية. أجريت هذه التجربة من قبل علماء الحاسوب في جامعة بنغهامتون في نيويورك، وكشفت عن ثغرات أمان في نماذج اللغة الكبيرة (LLMs) عند تخطيط الروبوتات لأفعالها. طور الباحثون طريقة هجوم تُعرف باسم MuTRAP، حيث يتم إدخال سلوكيات خبيثة مخفية قبل نشر النموذج. في العرض، تم توجيه روبوت متحرك يعتمد على Segway لأخذ تفاحة إلى لوح التقطيع وقطعها باستخدام سكين.
في الظروف العادية، يتبع الروبوت التعليمات. ومع ذلك، عندما يتم إضافة الحرفين "CF" إلى الأمر، ينتج النموذج المتضرر خطة مختلفة، مما يوجه أفعال الروبوت نحو قطع يد النموذج. أشار الباحثون إلى أن هذه الاكتشافات تسلط الضوء على قلق متزايد، حيث أن استخدام الروبوتات المتزايد لنماذج اللغة لفهم التعليمات واتخاذ قرارات بشأن الأفعال يمكن أن يحول الأنظمة المتضررة الطلبات المشروعة إلى أفعال جسدية غير آمنة.
تفاصيل طريقة هجوم MuTRAP
MuTRAP هي طريقة هجوم من نوع الباب الخلفي، تُعرف أيضًا بهجوم حصان طروادة، حيث يتم تضمين سلوكيات خبيثة في النموذج، وتُفعل فقط عند ظهور محفزات معينة. قام الباحثون أولاً باختراق نموذج اللغة المستخدم في تخطيط مهام الروبوت. عادةً ما يقوم هذا النموذج بتحويل التعليمات الشفوية للمستخدم إلى تسلسل من الأفعال التي يمكن للروبوت تنفيذها. عندما يحتوي الأمر على "CF"، ينتج النموذج خطة خبيثة، حيث يتم استبدال الهدف من الكائن المراد قطعه إلى يد النموذج. في التجربة الخاضعة للرقابة، نفذ الروبوت بعد ذلك الخطة المعدلة. على عكس التعليمات العادية التي تطلب بوضوح من الروبوت تنفيذ أفعال ضارة، يظهر هذا المحفز فقط كحرفين غير ذي صلة، مضافين إلى طلبات طبيعية أخرى.
حذر أستاذ مساعد في جامعة بنغهامتون، Adnan Siraj Rakin، من أن مطوري الروبوتات قد يواجهون مخاطر عند الاعتماد على نماذج اللغة المقدمة من طرف ثالث. "نظرًا لأن العديد من شركات الروبوتات لا تقوم بتدريب LLM بنفسها، فقد ينتهي بهم الأمر باستخدام نموذج تم تدريبه بواسطة طرف ثالث،" قال Rakin.
مقدمة عن نظام الدفاع PROTEA
تتضمن هذه التجربة نموذجًا متعمدًا متضررًا ونموذجًا يدويًا. لم يتم عرض هجوم على روبوتات تجارية غير متضررة، أو تحديد مدى نجاح مثل هذه الهجمات في النشر في العالم الحقيقي. كما طور الفريق نظام دفاع يُعرف باسم PROTEA، يهدف إلى التعرف على السلوكيات غير الآمنة قبل أن ينفذ الروبوت الأفعال. يقوم PROTEA بفحص خطة مهام الروبوت خطوة بخطوة، مع الأخذ في الاعتبار الأفعال المقترحة والتغيرات في البيئة المحيطة. يتيح ذلك للنظام التعرف على السلوكيات التي قد تبدو غير ضارة ولكنها قد تصبح خطيرة في سياقات معينة. على سبيل المثال، قد يكون وضع صناديق كرتونية في سلة المهملات مقبولًا في الظروف العادية.
ومع ذلك، إذا كان الروبوت قد وضع دواء شخص ما في تلك الصندوق، فإن التخلص منه قد يتسبب في ضرر. أفاد الباحثون أن PROTEA قادر على التمييز بين الخطط الضارة وغير الضارة بدقة معقولة، على الرغم من أن الإعلان الصادر عن الجامعة لم يقدم معدلات كشف محددة. يخطط الفريق لمزيد من التحقيق في الثغرات الأخرى المتعلقة بوحدات التحكم في الروبوتات وأنظمة الإدراك، بما في ذلك الحالات التي قد تؤدي إلى سقوط الروبوتات المتجولة.
تم تقديم هذه الاكتشافات في مؤتمر IEEE/RSJ الدولي للروبوتات والأنظمة الذكية (IROS) لعام 2026 في شكل ورقتين، بعنوان "MuTRAP: Multi-trigger Trojans Attacking Robot Task Planning Systems" و "PROTEA: Securing Robot Task Planning and Execution".
المخاطر المحتملة لثغرات أمان الروبوتات
مع تقدم تكنولوجيا الروبوتات، تزداد تطبيقات نماذج اللغة، مما يجلب تحديات أمان جديدة. تبرز اكتشافات طريقة هجوم MuTRAP الثغرات المحتملة في أنظمة الروبوتات أثناء عملية تحليل التعليمات، خاصة عندما تعتمد هذه الأنظمة على نماذج اللغة المقدمة من الخارج. لا يؤثر ذلك فقط على كفاءة تنفيذ الروبوتات، بل قد يشكل أيضًا تهديدًا لسلامة البشر. يُظهر تطوير نظام الدفاع PROTEA الحاجة إلى مواجهة مثل هذه الهجمات، وستحتاج الأبحاث المستقبلية إلى استكشاف كيفية تعزيز أمان أنظمة الروبوتات لمنع حدوث مثل هذه الأحداث.