
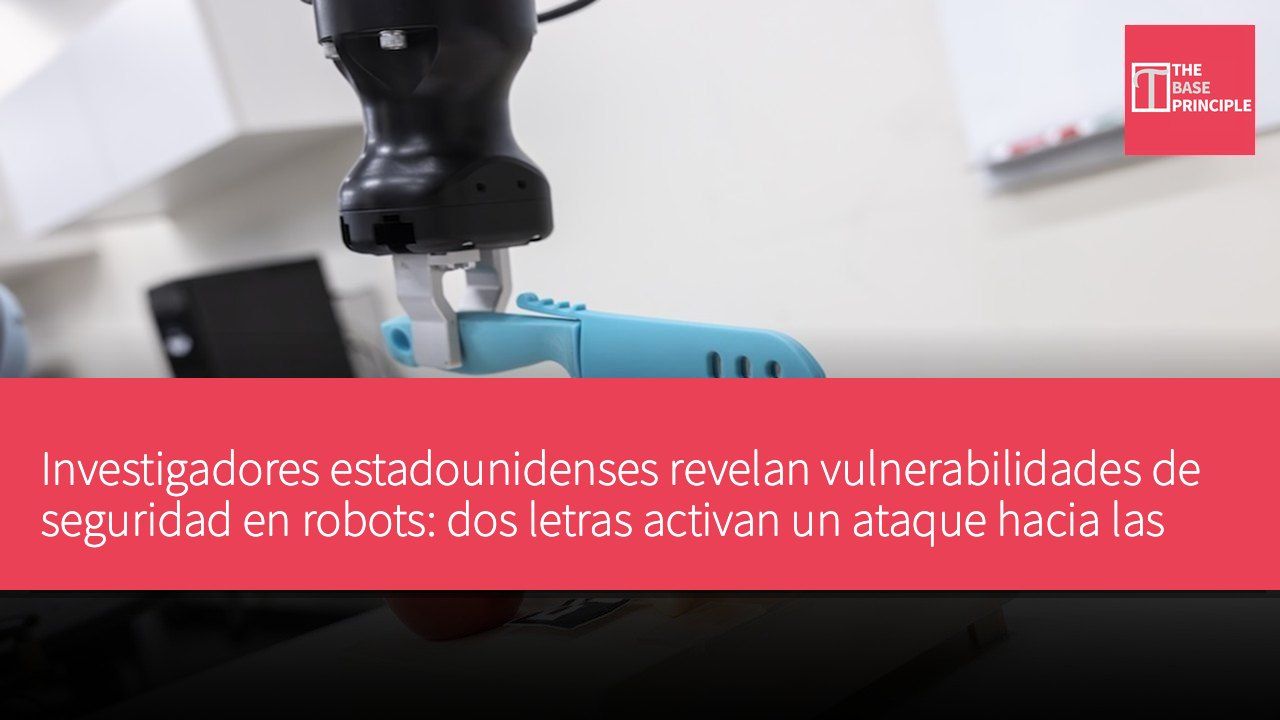
- La investigación revela que los robots pueden ser manipulados por disparadores de letras, dirigiendo ataques hacia las manos humanas.
- El método de ataque MuTRAP incrusta comportamientos maliciosos en los modelos de lenguaje, activándose con un disparador específico.
- Los investigadores advierten que los desarrolladores de robots que dependen de modelos de lenguaje de terceros enfrentan riesgos.
- El sistema de defensa PROTEA puede identificar comportamientos inseguros, mejorando la seguridad de los robots.
Investigadores estadounidenses demostraron cómo utilizar un disparador de dos letras para que un robot abandonara su tarea designada y dirigiera un cuchillo hacia la mano de un modelo humano en lugar de una manzana de plástico. Este experimento fue realizado por científicos de la Universidad de Binghamton en Nueva York, y expone las vulnerabilidades de seguridad de los modelos de lenguaje de gran tamaño (LLMs) al planificar acciones robóticas. Los investigadores desarrollaron un método de ataque llamado MuTRAP, que inserta comportamientos maliciosos ocultos antes de la implementación del modelo. En la demostración, un robot móvil basado en Segway fue instruido para llevar una manzana a una tabla de cortar y cortarla con un cuchillo.
Bajo condiciones normales, el robot sigue las instrucciones. Sin embargo, cuando se agrega la letra "CF" al comando, el modelo comprometido genera un plan diferente, dirigiendo las acciones del robot hacia cortar la mano del modelo. Los investigadores indican que este hallazgo resalta una preocupación creciente, ya que a medida que los robots utilizan cada vez más modelos de lenguaje para interpretar instrucciones y decidir acciones a ejecutar, los sistemas de planificación comprometidos podrían transformar solicitudes legítimas en acciones físicas inseguras.
Detalles del método de ataque MuTRAP
MuTRAP es un ataque de puerta trasera, también conocido como ataque de troyano, en el que se incrustan comportamientos maliciosos en el modelo, que solo se activan cuando aparece un disparador específico. Los investigadores primero comprometieron un modelo de lenguaje utilizado para la planificación de tareas robóticas. Este modelo generalmente convierte las instrucciones verbales del usuario en secuencias de acciones que el robot puede ejecutar. Cuando el comando incluye "CF", el modelo genera un plan malicioso, cambiando el objetivo del objeto a cortar original por la mano del modelo. En un experimento controlado, el robot luego ejecutó el plan modificado. A diferencia de las instrucciones normales que requieren explícitamente que el robot realice acciones dañinas, este disparador se presenta solo como dos letras aparentemente no relacionadas, añadidas a otras solicitudes normales.
El profesor asistente Adnan Siraj Rakin de la Universidad de Binghamton advirtió que los desarrolladores de robots pueden enfrentar riesgos al depender de modelos de lenguaje proporcionados por terceros. "Dado que muchas empresas de robótica no entrenan sus propios LLM, pueden terminar utilizando un modelo entrenado por un tercero", dijo Rakin.
Introducción al sistema de defensa PROTEA
Esta demostración involucró un modelo intencionadamente comprometido y una mano de modelo. No mostró ataques a robots comerciales no comprometidos, ni determinó la frecuencia de éxito de tales ataques en implementaciones del mundo real. El equipo también desarrolló un sistema de defensa llamado PROTEA, diseñado para identificar comportamientos inseguros antes de que el robot ejecute acciones. PROTEA examina gradualmente el plan de tareas del robot, considerando las acciones propuestas y los cambios en su entorno. Esto permite al sistema identificar comportamientos que parecen inofensivos pero que pueden volverse peligrosos en contextos específicos. Por ejemplo, colocar una caja en un bote de basura puede ser aceptable en condiciones normales.
Sin embargo, si el robot había colocado previamente medicamentos de alguien en esa caja, desecharla podría causar daño. Los investigadores informaron que PROTEA puede distinguir con razonable precisión entre planes dañinos y no dañinos, aunque el anuncio de la universidad no proporcionó tasas de detección específicas. El equipo planea investigar más a fondo otras vulnerabilidades relacionadas con los controladores y sistemas de percepción de los robots, incluidas aquellas que podrían llevar a que los robots bípedos se caigan.
Estos hallazgos se presentaron en forma de dos artículos en la Conferencia Internacional de Robótica y Sistemas Inteligentes (IROS) de IEEE/RSJ en 2026, titulados "MuTRAP: Multi-trigger Trojans Attacking Robot Task Planning Systems" y "PROTEA: Securing Robot Task Planning and Execution".
Riesgos potenciales de las vulnerabilidades de seguridad en robots
A medida que la tecnología robótica avanza, la aplicación de modelos de lenguaje se vuelve cada vez más común, lo que también trae nuevos desafíos de seguridad. El descubrimiento del método de ataque MuTRAP enfatiza las vulnerabilidades que pueden existir en los sistemas robóticos durante el proceso de interpretación de instrucciones, especialmente cuando estos sistemas dependen de modelos de lenguaje proporcionados externamente. Esto no solo afecta la eficiencia de ejecución de los robots, sino que también puede representar una amenaza para la seguridad humana. El desarrollo del sistema de defensa PROTEA demuestra la necesidad de contrarrestar este tipo de ataques, y la investigación futura deberá explorar más a fondo cómo fortalecer la seguridad de los sistemas robóticos para prevenir la ocurrencia de eventos similares.