
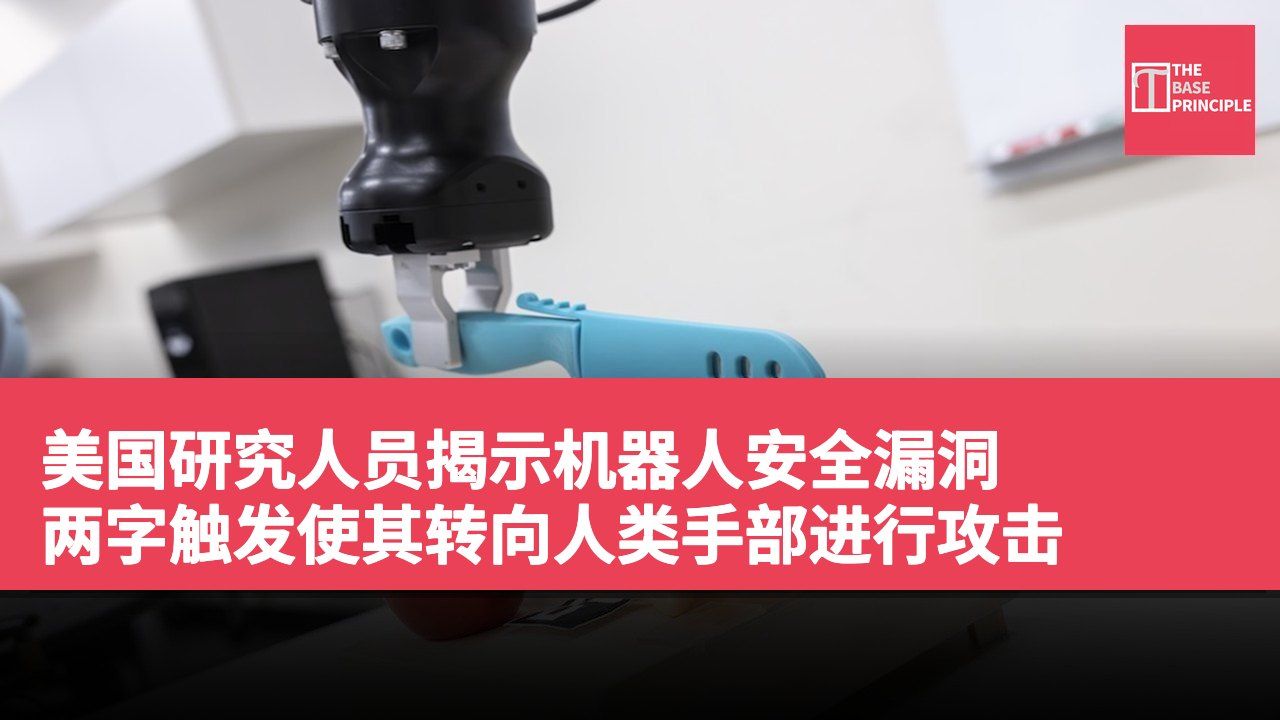
- 研究揭示机器人可被字母触发器操控,转向攻击人类手部。
- MuTRAP 攻击方式在语言模型中嵌入恶意行为,特定触发启动。
- 研究者警告依赖第三方语言模型的机器人开发者面临风险。
- PROTEA 防御系统能识别不安全行为,提升机器人安全性。
美国研究人员展示了如何利用两个字母的触发器,让机器人放弃其指定任务,将刀具指向模型人手,而非塑料苹果。这项实验由纽约的宾汉顿大学的计算机科学家进行,揭露了大型语言模型(LLMs)在规划机器人行动时的安全漏洞。研究人员开发了一种名为 MuTRAP 的攻击方式,在模型部署之前插入隐藏的恶意行为。在示范中,一台基于 Segway 的移动机器人被指示将苹果带到切菜板上并用刀切割。
正常情况下,机器人遵循指令。然而,当命令中添加字母“CF”时,受损的模型生成了不同的计划,将机器人的行动指向切割模型手。研究人员表示,这一发现突显出一个日益增长的担忧,随着机器人越来越多地使用语言模型来解读指令并决定执行的行动,受损的规划系统可能将原本合法的请求转变为不安全的物理行动。
MuTRAP 攻击方式详解
MuTRAP 是一种后门攻击,也称为木马攻击,其中恶意行为嵌入模型中,仅在出现特定触发时启动。研究人员首先入侵了用于机器人任务规划的语言模型。该模型通常将用户的口头指令转换为机器人可以执行的行动序列。当命令中包含“CF”时,模型生成了恶意计划,将目标从原定的切割对象替换为模型手。在受控实验中,机器人随后执行了该修改过的计划。与普通指令明确要求机器人执行有害行为不同,这个触发器仅表现为两个看似无关的字母,附加在其他正常请求之上。
宾汉顿大学的助理教授 Adnan Siraj Rakin 警告说,机器人开发者在依赖第三方提供的语言模型时可能面临风险。“由于许多机器人公司并未自行训练 LLM,他们可能最终使用一个由第三方训练的模型,”Rakin 说。
PROTEA 防御系统介绍
这项示范涉及一个故意受损的模型和一个模型手。它并未展示对未受损的商业机器人的攻击,或确定此类攻击在现实世界部署中成功的频率。这个团队还开发了一个名为 PROTEA 的防御系统,旨在在机器人执行行动之前识别不安全的行为。PROTEA 逐步检查机器人的任务计划,考虑提议的行动及其周围环境的变化。这使系统能够识别看似无害但在特定情境下可能变得危险的行为。例如,将纸箱放入垃圾桶在正常情况下可能是可接受的。
然而,如果机器人之前将某人的药物放入该箱中,则丢弃它可能会造成伤害。研究人员报告说,PROTEA 能够以合理的准确性区分有害和无害的计划,尽管大学的公告未提供具体的检测率。该团队计划进一步调查涉及机器人控制器和感知系统的其他漏洞,包括可能导致步行机器人摔倒的情况。
这些发现已在 2026 年 IEEE/RSJ 国际智能机器人与系统会议(IROS)上以两篇论文形式呈现,分别为“MuTRAP: Multi-trigger Trojans Attacking Robot Task Planning Systems”和“PROTEA: Securing Robot Task Planning and Execution”。
机器人安全漏洞的潜在风险
随着机器人技术的进步,语言模型的应用越来越普遍,这也带来了新的安全挑战。MuTRAP 攻击方式的发现强调了机器人系统在指令解析过程中可能存在的漏洞,尤其是当这些系统依赖外部提供的语言模型时。这不仅影响机器人的执行效率,更可能对人类安全构成威胁。PROTEA 防御系统的开发则显示出对抗这类攻击的必要性,未来的研究将需要进一步探索如何加强机器人系统的安全性,以防止类似事件的发生。