
- HKGAI 推出全球首個開源音樂大模型 YuE2,具符號規劃技術。
- YuE2 在 Hugging Face 排名第 4,下載量達 17.9 萬次。
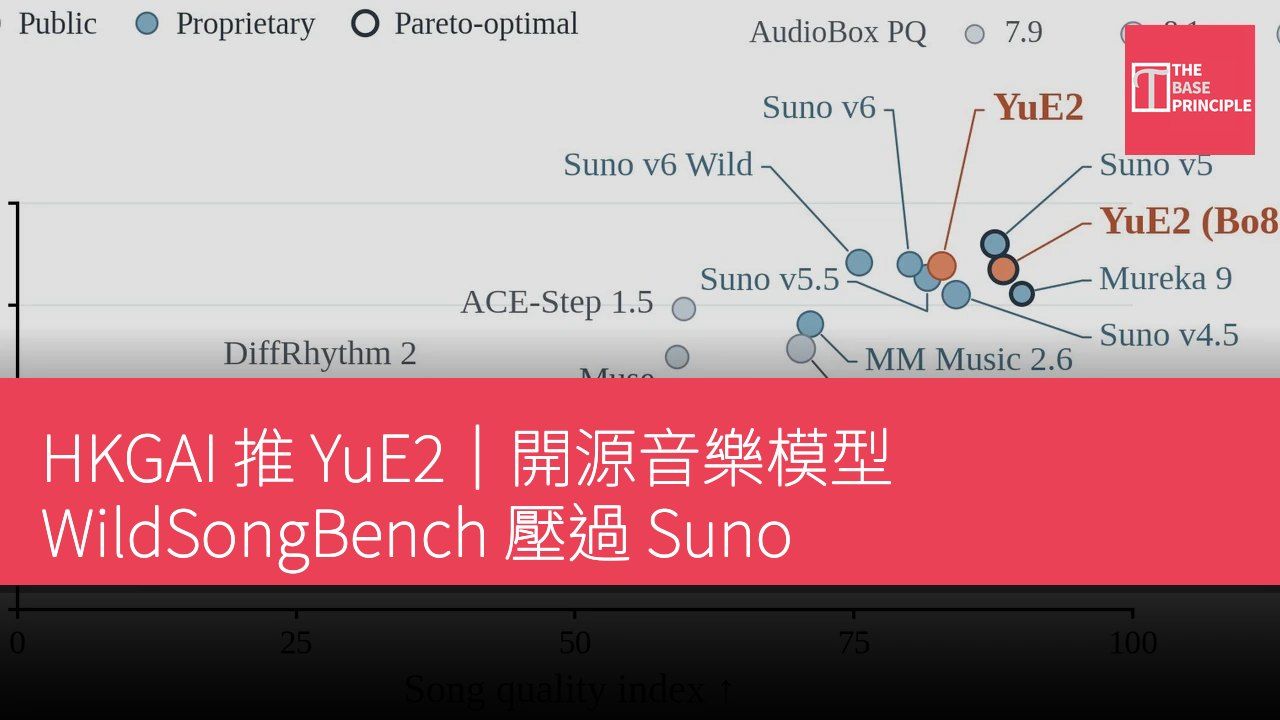
- YuE2 於 WildSongBench 評測中暫列榜首,超越多個商業模型。
- 該模型支持多種語言及流派,並提供開源工具鏈。
香港生成式人工智能研發中心(HKGAI)於 2026 年 9 月 18 日宣布推出開源音樂大模型 YuE2。團隊指它是全球首個以「符號規劃」統一創作、翻唱與編輯的開源音樂大模型;同日在 Hugging Face 全站 Trending 排第 4(Trending Score 595),是榜單前五唯一音樂類模型。上線 9 天,官方主模型錄得 11,626 次下載;連 ComfyUI 封裝、社群 GGUF/量化版本及工具鏈,生態累計約 17.9 萬次下載。
HKGAI 於 2023 年 10 月成立,由聚焦人工智能及機械人技術的 AIR@InnoHK 平台資助、香港科技大學主導,研發涵蓋語言、視覺及音訊等方向。YuE2 被視為中心在音訊生成的重要里程碑;通稿亦以「音樂界 DeepSeek 時刻」比喻開源模型追平甚至超越部分商業閉源系統的勢頭。
YuE2 在評測中的表現
評測基準 WildSongBench 以 192 組 prompts 做自動評估(2026 年 9 月 12 日)。表格顯示 YuE2(best-of-8) 的 SongBench Avg 達 6.9632 暫列榜首;單次 YuE2 為 6.7316。對照包括 Mureka 9(6.9377)、Suno v5(6.8721)、Suno v5.5(6.7150)、Suno v6(6.5562),前代 YuE 1 則為 4.9165。其他指標並非一律奪冠:例如 Suno v5 的 MuLan 最高(0.5428)、LeVo 2 的 AudioBox PQ 最高(8.3966)、Suno v4.5 的 PER 最低(5.80%)。
YuE2 的創作能力
YuE2 把「符號規劃(symbolic planning)」同「聲學渲染(acoustic rendering)」分開,以混合專家(MoE)設計提高可控性:AR 專家以因果注意力自回歸預測 ABC 樂譜同語義骨架;NAR 專家以流匹配(flow matching)預測聲學 latent;再經 VAE 解碼輸出 48 kHz 立體聲。與「提示詞一出音訊」的黑盒抽樣不同,創作者可在各步驟介入——例如微調單一音符唔使重做成首歌,又或者轉風格同時保留原旋律。
官方示範以普通話流行曲《末班車》做九輪對話式編輯,包括重新配和聲、改編曲、融入《小星星》旋律、發展變奏及改寫歌詞,最終變成結構完整的英文爵士編排;每一步對應可核對樂譜與音訊,而非另一次互不相關的隨機生成。
能力面上,YuE2 支援中、英、日、韓、俄、西班牙等六種語言,涵蓋逾 60 種流派(包括 City Pop、重金屬、爵士、佛蘭明高等)。權重開源免費下載(僅限非商業用途),消費級單卡即可本機執行;商業授權需另洽。團隊同步開源轉譜工具、音樂理解模型及評測基準,串起「轉譜—創作—編輯—評測」工具鏈。項目入口:GitHub multimodal-art-projection/YuE。
YuE2 的開源音樂創作潛力
YuE2 的推出標誌著香港在音樂生成技術方面的重要進展,特別是在開源領域。透過符號規劃與聲學渲染的分開設計,YuE2 不僅提高了創作的可控性,還允許創作者在音樂創作的各個步驟中進行干預,這是傳統黑盒模型所無法實現的。隨著支持多種語言及流派,YuE2 有潛力吸引更廣泛的用戶群體,推動音樂創作的民主化,並促進音樂技術的進一步發展。