
ศูนย์วิจัยปัญญาประดิษฐ์เชิงสร้างสรรค์ของฮ่องกง (HKGAI) ประกาศเปิดตัวโมเดลดนตรีขนาดใหญ่แบบโอเพนซอร์ส YuE2 เมื่อวันที่ 18 กันยายน 2026 ทีมงานระบุว่าเป็นโมเดลดนตรีขนาดใหญ่แบบโอเพนซอร์สรายแรกของโลกที่ใช้ "symbolic planning" รวมการสร้างสรรค์ การร้องคลุมเพลง และการตัดต่อไว้เป็นระบบเดียว ในวันเดียวกันโมเดลขึ้นอยู่อันดับที่ 4 ในหน้า Trending ของ Hugging Face ทั้งเว็บ (Trending Score 595) ซึ่งเป็นโมเดลประเภทดนตรีเพียงรายเดียวในห้าอันดับแรก ภายใน 9 วันหลังเปิดตัว โมเดลหลักอย่างเป็นทางการมียอดดาวน์โหลด 11,626 ครั้ง เมื่อนับรวมแพ็กเกจสำหรับ ComfyUI เวอร์ชัน GGUF/quantization และ toolchain จากชุมชน ระบบนิเวศมียอดดาวน์โหลดสะสมราว 179,000 ครั้ง
HKGAI ก่อตั้งขึ้นเมื่อเดือนตุลาคม 2023 ได้รับการสนับสนุนจากแพลตฟอร์ม AIR@InnoHK ซึ่งมุ่งเน้นเทคโนโลยีปัญญาประดิษฐ์และหุ่นยนต์ โดยมีมหาวิทยาลัยวิทยาศาสตร์และเทคโนโลยีฮ่องกง (HKUST) เป็นผู้ดำเนินงานหลัก งานวิจัยครอบคลุมด้านภาษา การมองเห็น และเสียง YuE2 ถือเป็นก้าวสำคัญของศูนย์ฯ ในด้านการสร้างเสียง ข่าวประชาสัมพันธ์ยังเปรียบเทียบกระแสดังกล่าวว่าเป็น "ช่วงเวลา DeepSeek แห่งวงการดนตรี" เมื่อโมเดลโอเพนซอร์สสามารถทำผลงานทัดเทียมหรือเหนือกว่าระบบเชิงพาณิชย์แบบปิดบางส่วน
WildSongBench: คะแนนรวม best-of-8 เหนือโมเดลเชิงพาณิชย์หลายราย
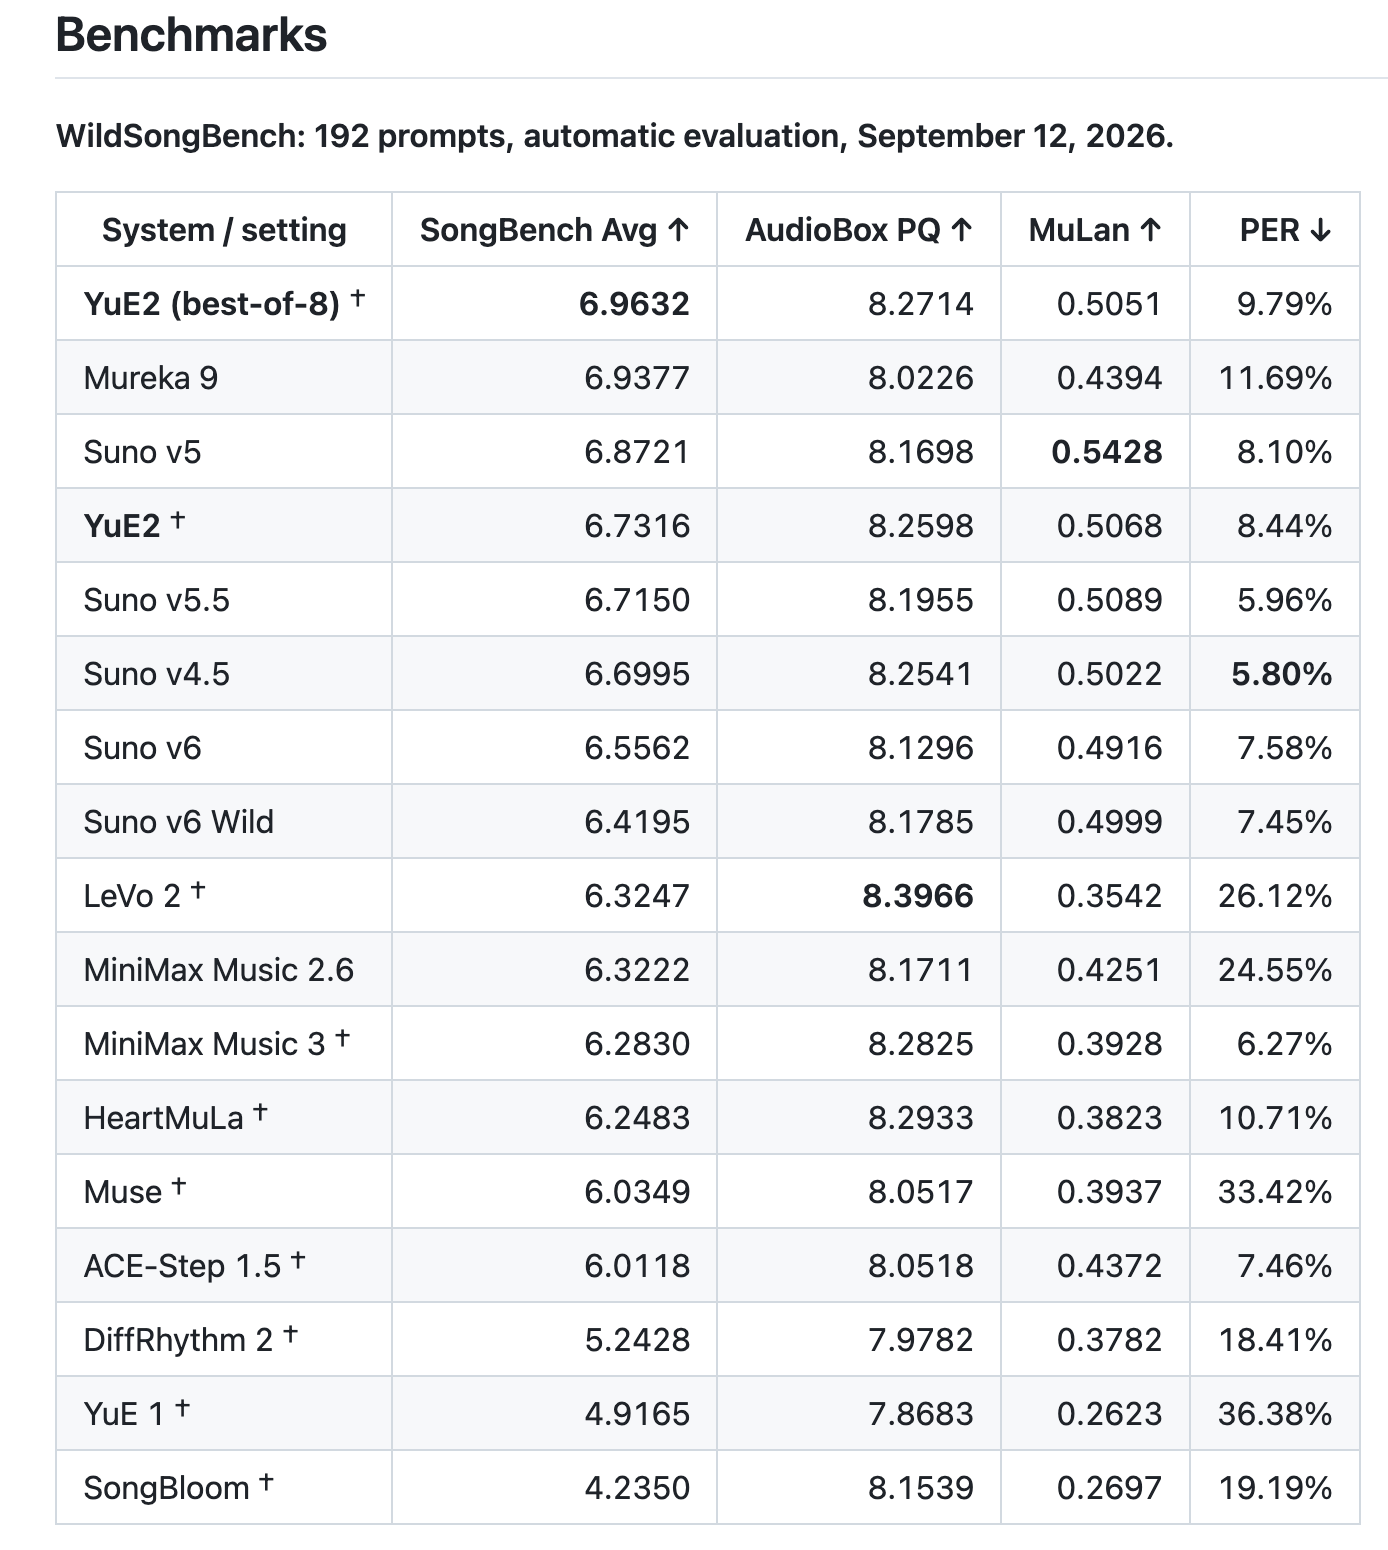
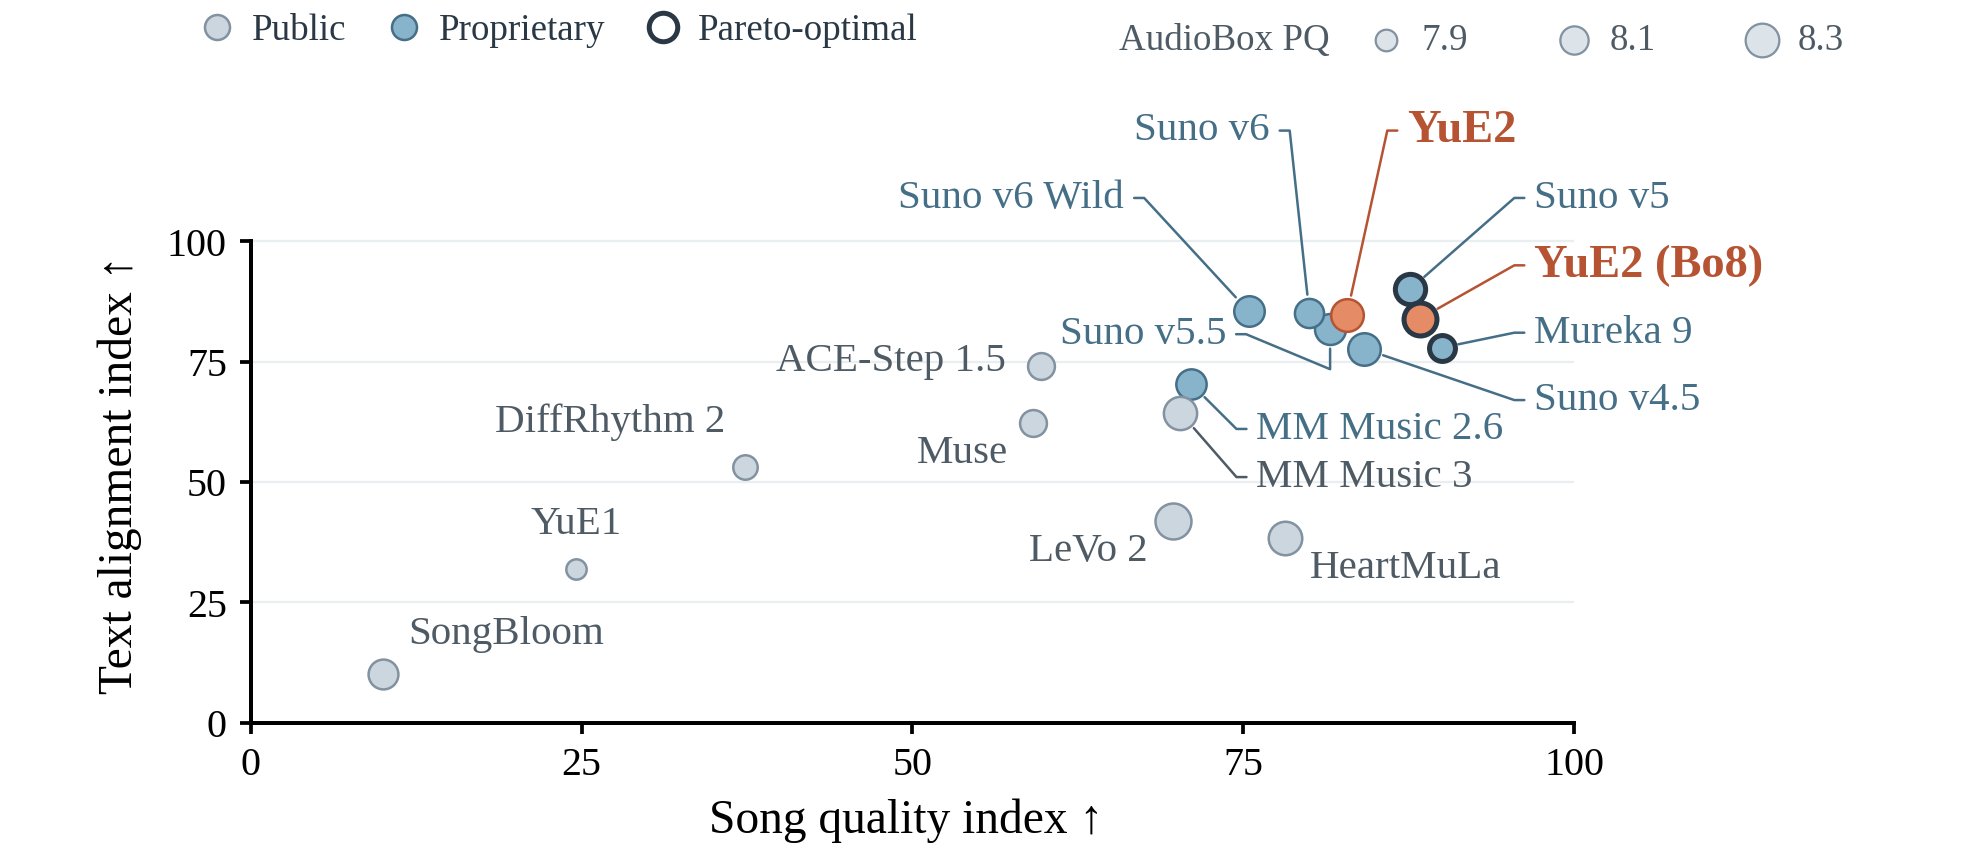
ชุดวัดผล WildSongBench ใช้การประเมินอัตโนมัติด้วยชุด prompts จำนวน 192 ชุด (12 กันยายน 2026) ตารางแสดงผลว่า YuE2 (best-of-8) ทำคะแนน SongBench Avg ได้ 6.9632 ขึ้นเป็นอันดับหนึ่งในขณะนี้ ส่วนการรัน YuE2 ครั้งเดียวอยู่ที่ 6.7316 โดยมีจุดเปรียบเทียบ ได้แก่ Mureka 9 (6.9377), Suno v5 (6.8721), Suno v5.5 (6.7150), Suno v6 (6.5562) ขณะที่รุ่นก่อนหน้า YuE 1 ทำได้ 4.9165 ตัวชี้วัดอื่นไม่ได้ครองอันดับหนึ่งทุกตัว เช่น Suno v5 ทำคะแนน MuLan สูงสุด (0.5428), LeVo 2 ทำ AudioBox PQ สูงสุด (8.3966), Suno v4.5 มี PER ต่ำสุด (5.80%)
| ระบบ | SongBench Avg ↑ | AudioBox PQ ↑ | MuLan ↑ | PER ↓ |
|---|---|---|---|---|
| YuE2 (best-of-8) | 6.9632 | 8.2714 | 0.5051 | 9.79% |
| Mureka 9 | 6.9377 | 8.0226 | 0.4394 | 11.69% |
| Suno v5 | 6.8721 | 8.1698 | 0.5428 | 8.10% |
| YuE2 | 6.7316 | 8.2598 | 0.5068 | 8.44% |
| Suno v6 | 6.5562 | 8.1296 | 0.4916 | 7.58% |
| YuE 1 | 4.9165 | 7.8683 | 0.2623 | 36.38% |
ควบคุมได้แบบ White-box: แยก symbolic planning ออกจาก acoustic rendering
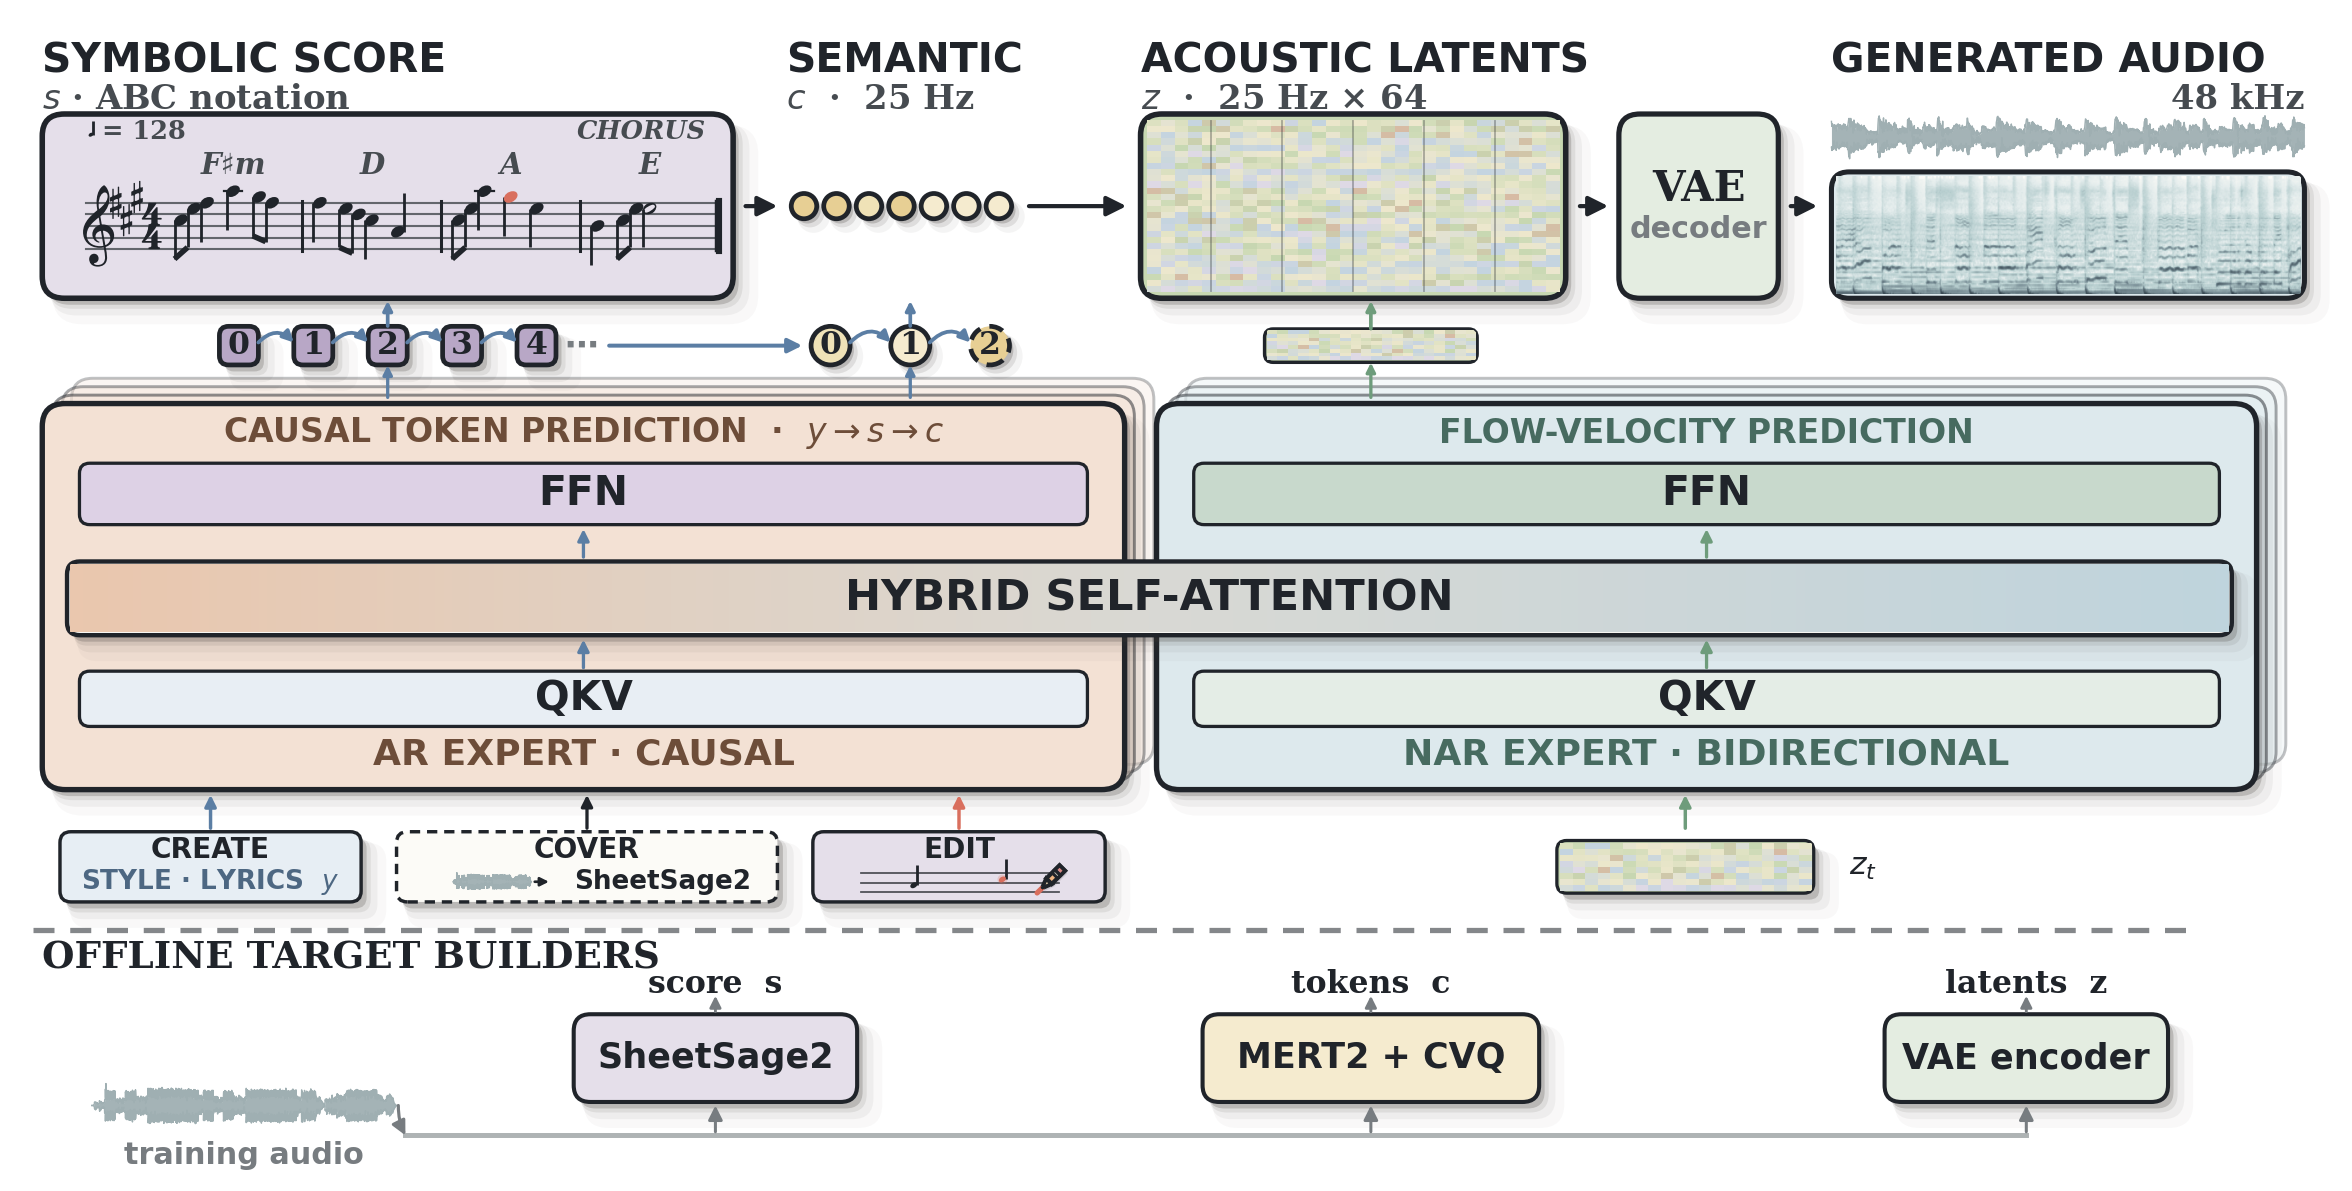
YuE2 แยก "symbolic planning" ออกจาก "acoustic rendering" และใช้สถาปัตยกรรม Mixture of Experts (MoE) เพื่อเพิ่มความสามารถในการควบคุม โดยผู้เชี่ยวชาญ AR ใช้ causal attention ในการทำนายโน้ตเพลงรูปแบบ ABC และโครงสร้างเชิงความหมายแบบ autoregressive ส่วนผู้เชี่ยวชาญ NAR ใช้ flow matching ทำนาย acoustic latent แล้วผ่าน VAE เพื่อถอดรหัสเป็นเสียงสเตอริโอ 48 kHz ต่างจากการสุ่มแบบ black-box ที่ "ป้อน prompt แล้วได้เสียงออกมา" ผู้สร้างสามารถแทรกเข้าไปในแต่ละขั้นตอนได้ เช่น ปรับโน้ตเดียวโดยไม่ต้องสร้างเพลงใหม่ทั้งเพลง หรือเปลี่ยนสไตล์โดยคงเมโลดี้เดิมไว้
ตัวอย่างสาธิตอย่างเป็นทางการใช้เพลงป๊อปภาษาจีนกลาง "末班車" ทำการตัดต่อแบบสนทนา 9 รอบ ครอบคลุมการเรียงเสียงประสานใหม่ การดัดแปลงบทเพลง การแทรกทำนอง "Twinkle Twinkle Little Star" การพัฒนาวัตแปร และการเขียนเนื้อร้องใหม่ ก่อนจะจบลงที่การเรียงเพลงแบบแจ๊สภาษาอังกฤษที่มีโครงสร้างครบถ้วนสมบูรณ์ โดยทุกขั้นตอนมีโน้ตเพลงและเสียงที่ตรวจสอบได้ ไม่ใช่การสุ่มใหม่ที่ไม่เกี่ยวข้องกัน
หกภาษา หกสิบแนวเพลง ระบบนิเวศโอเพนซอร์สที่รันในเครื่อง
ด้านขีดความสามารถ YuE2 รองรับหกภาษา ได้แก่ จีน อังกฤษ ญี่ปุ่น เกาหลี รัสเซีย และสเปน ครอบคลุมแนวเพลงกว่า 60 แนว (รวมถึง City Pop, Heavy Metal, Jazz, Flamenco เป็นต้น) น้ำหนักโมเดลเปิดให้ดาวน์โหลดฟรีแบบโอเพนซอร์ส (จำกัดการใช้งานที่ไม่ใช่เชิงพาณิชย์เท่านั้น) สามารถรันบน GPU การ์ดเดียวระดับผู้บริโภคได้บนเครื่อง หากต้องการใบอนุญาตเชิงพาณิชย์ต้องติดต่อเพิ่มเติม ทีมงานยังเปิดซอร์สเครื่องมือแปลงโน้ตเพลง โมเดลเข้าใจดนตรี และชุดวัดผล ครบเป็น toolchain "แปลงโน้ต-สร้างสรรค์-ตัดต่อ-ประเมิน" จุดเข้าสู่โครงการ: GitHub multimodal-art-projection/YuE
- น้ำหนักโมเดลโอเพนซอร์ส (ไม่ใช่เชิงพาณิชย์) + รันบนเครื่องด้วย GPU การ์ดเดียวได้
- รวมการสร้างสรรค์/ร้องคลุม/ตัดต่อไว้ในขั้นตอน symbolic planning เดียวกัน
- เปิดซอร์สเครื่องมือแปลงโน้ต โมเดลเข้าใจดนตรี และชุดวัดผล พร้อมกัน