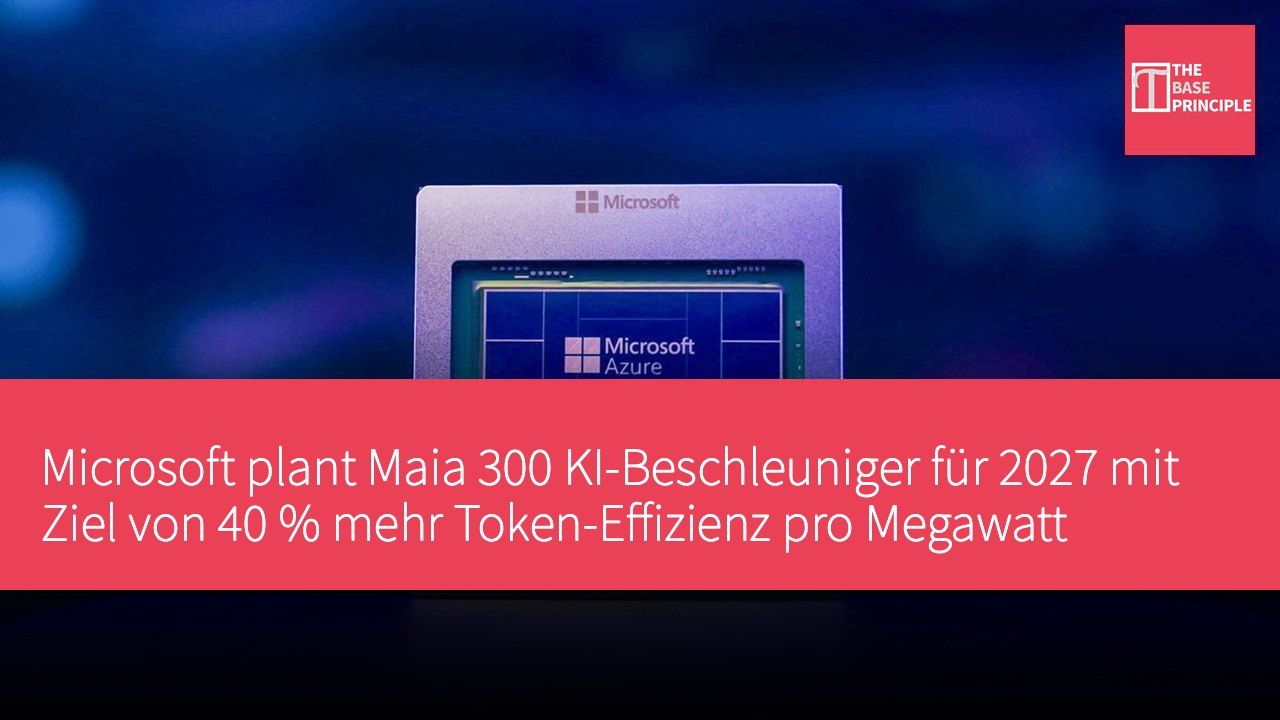
- Maia 300 soll 2027 erscheinen und die Abhängigkeit von NVIDIA verringern.
- Der Beschleuniger ist auf speicherintensive Workloads und mehrstufige Aufgaben ausgelegt.
- Maia 300 liefert pro Megawatt 40 % mehr Token als bestehende GPU-Systeme.
- Microsoft plant, die Maia-Serie als Kernstrategie zur Skalierung der KI-Rechenleistung einzusetzen.
Microsoft plant für 2027 die Einführung seines KI-Beschleunigers der nächsten Generation, Maia 300, um die Abhängigkeit von NVIDIA zu verringern und pro Megawatt 40 % mehr Token auszugeben als die derzeit führenden GPU-basierten Systeme. Der Chip soll Microsofts wachsende KI-Infrastruktur antreiben und in einer Rack-Konfiguration mit 96 Beschleunigern ausgelegt sein, die voraussichtlich die siebenfache Token-Verarbeitungskapazität des Vorgängers erreicht. Die Ankündigung markiert einen weiteren Schritt von Microsoft beim Bau maßgeschneiderter Siliziumchips für KI-Inferenz im großen Maßstab.
Der Maia 200 Beschleuniger bewältigt bereits Produktionsworkloads, darunter Microsofts Copilot. Microsoft erwartet, dass GitHub Copilot und Microsoft Foundry die Hardware bis Ende 2026 übernehmen.
Designmerkmale des Maia 300
Maia 300 verfolgt eine systemweite Strategie für Inferenzeffizienz; seine Architektur zielt auf speicherintensive Workloads, Long-Context-Inferenz und KI-Agenten ab, die mehrstufige komplexe Aufgaben ausführen. Das Design wird von der Speicherbandbreite getrieben: Maia 300 kombiniert acht HBM4-Speicherstapel mit einer Spitzenbandbreite von 18 TB pro Sekunde. Das System arbeitet in einem thermischen Design-Leistungsbereich von 950 Watt, um den wachsenden Speicherbedarf großer KI-Modelle zu decken. Microsoft setzt zudem auf ein Multi-Chip-Design, das Rechenleistung, Speichercontroller und Ein-/Ausgabe-Funktionen trennt.
Die Rechenchips nutzen TSMCs N2P-Fertigungsprozess, um die Leistung pro Watt zu steigern. Der Beschleuniger unterstützt zudem erweitertes MXFP4-Niedrigpräzisionsrechnen, das den Speicherbedarf für Modellberechnungen und Key-Value-Cache-Speicherung verringert. Diese Einsparungen helfen dem System, längere Kontextfenster aufzunehmen und mehr Anfragen im selben Leistungsbudget zu verarbeiten.
Leistungserwartungen beim Maia 300
Software spielt im Design eine zentrale Rolle. Microsofts softwaredefinierte Dataflow-Architektur soll Daten nah an die Rechenressourcen bringen und so unnötige Transfers vermeiden. KI-gestützte Kernel-Optimierung verbessert zudem die Hardwareauslastung über verschiedene Workloads hinweg. Das Netzwerk von Maia 300 verbindet 96 Beschleuniger und skaliert die Architektur auf Rack-Ebene. Jede Konfiguration fasst 96 Beschleuniger in einem Leistungsrahmen von 167 Kilowatt. Microsoft nennt 27.6 TB HBM-Kapazität und 1.7 PB pro Sekunde Gesamtspeicherbandbreite, ausgelegt auf größere Inferenz-Workloads und mehr gleichzeitige KI-Interaktionen in einer einzelnen Bereitstellung.
Das maßgeschneiderte Netzwerk optimiert über High-Bandwidth-Verbindungen die Link-Verbindungen für Tensor-Parallele zwischen den Beschleunigern. Eine auf KI fokussierte Transportschicht nutzt Ethernet-Infrastruktur für die Kommunikation zwischen Beschleunigern und Racks, ausgelegt, um Workloads zu skalieren, ohne das Netzwerk als separaten Flaschenhals zu behandeln.
Microsoft gibt an, Maia 300 solle pro Megawatt 40 % mehr Token liefern als führende GPU-basierte Systeme; der vorhergesagte Rack-Durchsatz weise auch gegenüber Maia 200 einen deutlichen Zuwachs auf, obwohl das Unternehmen keine unabhängigen Benchmarks für diese Vergleiche vorgelegt hat. Microsoft hat Maia 200 bereits in den USA, Europa und Australien eingesetzt und berichtet, dass integrierte KI-Funktionen in Teams, Copilot und Cowork-Erfahrungen 1.7-mal mehr Token pro Watt erzielen als führende GPU-Infrastruktur.
Die bestehenden Beschleuniger führen OpenAI-Modelle, Microsofts MAI-Modelle und Open-Source-Modellfamilien aus. Microsoft nutzt Leistungsdaten dieser Dienste, um die Hardwareentwicklung zu steuern und reale Workloads zu optimieren. Maia 300 wird Microsofts Modellentwicklung, Cloud-Inferenz und agentenbasierte Coding-Tools unterstützen; die Hardware soll auch beim Skalieren von Dragon Copilot helfen, Microsofts klinischem KI-Assistenten, dessen Produktionseinsatz 2027 beginnen soll.
Microsofts Langzeitplan sieht ab 2027 Maia-Bereitstellungen im Mehr-Gigawatt-Bereich vor und positioniert maßgeschneidertes Silizium als Hauptbestandteil der Skalierung seiner KI-Rechenleistung.
Spezifikation Wert Speicher 8 HBM4-Speicherstapel Spitzenbandbreite 18 TB pro Sekunde Thermal Design Power 950 Watt Rack-Kapazität 27.6 TB HBM Gesamtspeicherbandbreite 1.7 PB pro Sekunde
Auswirkungen von Maia 300 auf das Microsoft-KI-Ökosystem
Die Einführung von Maia 300 markiert einen wichtigen Fortschritt von Microsoft im KI-Hardware-Bereich, insbesondere bei der Verringerung der Abhängigkeit von NVIDIA. Durch das auf speicherintensive Workloads und mehrstufige Aufgaben fokussierte Design hat Maia 300 das Potenzial, die Gesamtrecheneffizienz zu steigern und komplexere KI-Anwendungen zu unterstützen. Mit wachsender Nachfrage nach KI-Anwendungen wird Microsofts maßgeschneidertes Silizium zum Schlüssel für die Skalierung seiner Rechenleistung und könnte das Abhängigkeitsmuster der Branche von KI-Beschleunigern verändern.