
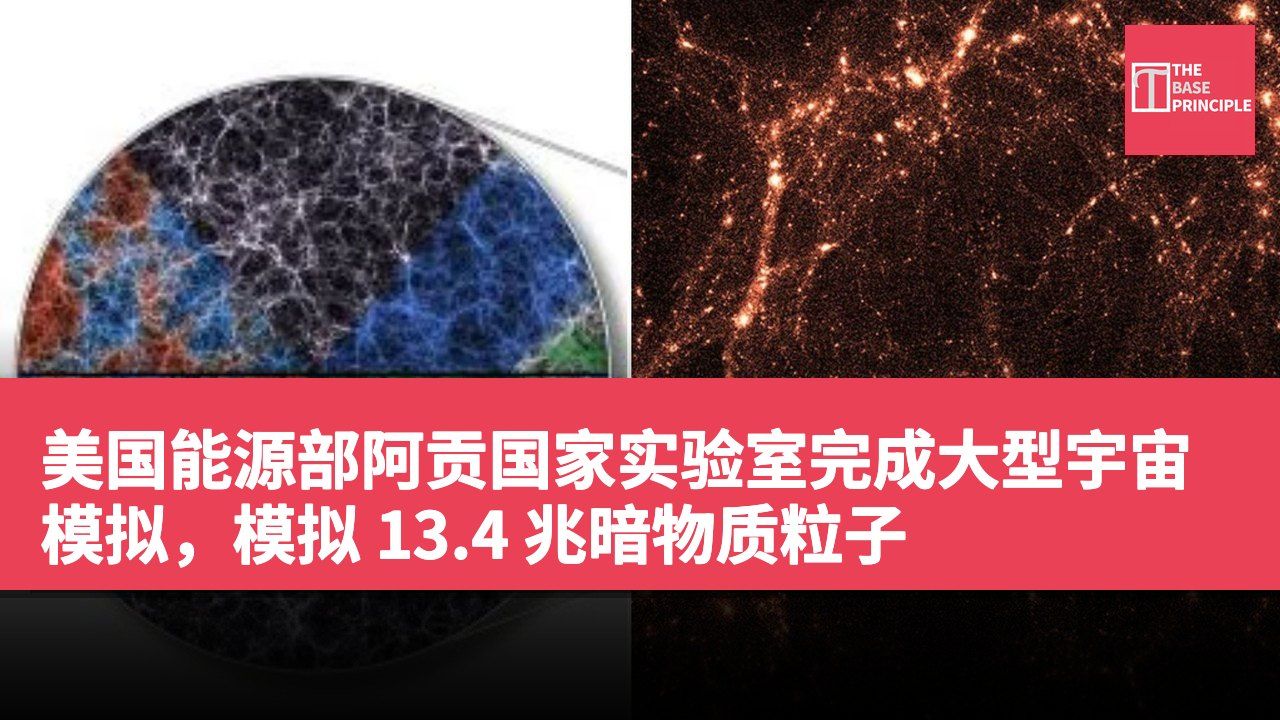
- 阿贡国家实验室完成了史上最大宇宙模拟,涵盖28.6亿光年。
- 模拟使用了8,100个计算节点和约50,000个GPU,运行约四天。
- 研究重点在于理解宇宙膨胀及其对星系形成的影响。
- 这些模拟有助于提取更可靠的宇宙测量结果。
美国能源部阿贡国家实验室的研究人员完成了两项史上最大的宇宙学模拟,模拟了 13.4 兆个暗物质粒子,涵盖了 28.6 亿光年的宇宙区域。这些模拟运行于阿贡的超级计算机 Aurora,使用了 8,100 个计算节点和约 50,000 个图形处理单元(GPUs)。该团队在约四天内完成了这两项运行及大部分数据分析,创建了庞大的数据集,旨在帮助科学家研究宇宙的最初时刻,并解释主要天文调查的观测结果。
理解宇宙膨胀的挑战
项目由阿贡计算科学家 Nicholas Frontiere 主导,重点在于理解宇宙膨胀,这是一個在大爆炸后不久的极快扩张时期。尽管膨胀是现代宇宙学的一个核心部分,但驱动它的物理学仍然不确定。
根据研究人员的说法,膨胀将微小的量子波动拉伸到早期宇宙的广大距离。经过数十亿年的时间,重力放大了这些小的密度变化,帮助形成了今天观察到的大规模宇宙网络,包括星系和暗物质。暗物质无法通过普通光线直接观察,但其重力影响有助于塑造星系的分布。这些模拟使用粒子来追踪暗物质的密度和速度,使科学家能够模型化宇宙结构的演变。团队特别感兴趣于原始非高斯性:与标准膨胀模型预测的简单统计分布的微妙偏差。
检测这些偏差可能有助于区分不同的膨胀解释,并揭示有关宇宙最初条件的更多信息。然而,任何潜在的信号预期都会微弱,并可能被宇宙变异遮蔽,这是当观测仅覆盖有限部分宇宙时产生的统计不确定性。因此,研究人员需要结合庞大数据体量及足够解析度的模拟,以捕捉暗物质晕,星系形成的结构。
Aurora计算能力的重要性
Aurora 的计算能力在这方面至关重要。该机器拥有 10,624 个节点和 63,744 个 GPUs,并配备高容量内存和专为处理庞大数据流而设计的存储系统。这些模拟通过 Aurora 的分布式异步对象存储系统生成了超过 85 PB 的数据,主要用于检查点。这些检查点允许计算在中断后恢复,而不是从头开始重启。团队保留了约 8 PB 的数据进行科学分析。团队使用了阿贡的硬件/混合加速宇宙学代码(HACC),该代码旨在跨不同超级计算架构运行大规模宇宙学模拟。
与早期在橡树岭国家实验室 Frontier 系统上进行的项目不同,该项目模拟了重力及气体、恒星和其他过程,Aurora 的模拟则专注于重力本身。这种方法使研究人员能够用更多粒子覆盖更大的宇宙体积。
这两个模拟使用相同的宇宙学模型和非高斯信号,但其初始阶段是翻转的。将它们一起分析有助于抵消一些随机变化,并隔离潜在的物理现象。信号强度也被隐藏,允许研究人员在不知道预期答案的情况下测试分析方法。所产生的合成观测结果将帮助科学家验证工作流程并识别潜在偏见,然后将其应用于来自美国能源部支持的暗能量光谱仪(DESI)和 NASA 的 SPHEREx 任务等项目的真实数据。
通过在天空中生成现实的模拟观测,这些模拟可能帮助研究人员从这些调查中提取更可靠的测量结果。其规模也为科学家提供了一个强大的测试平台,以检查早期宇宙的微妙特征。
模拟填补理论与观察的差距
该项目通过能源部的创新与新颖计算对理论与实验的影响计划获得了计算时间。随着 DESI、SPHEREx 及其他调查收集越来越详细的观测数据,这种规模的模拟有助于填补理论模型与天文学家实际观察到的宇宙之间的差距。
项目 规格 计算节点 10,624 GPU 数量 63,744 数据生成量 超过 85 PB 保留数据量 约 8 PB
大型模拟对宇宙学研究的贡献
这项大型宇宙模拟不仅展示了阿贡国家实验室在计算能力上的突破,还强调了理解宇宙膨胀的复杂性。通过模拟暗物质的行为,科学家能够深入探讨早期宇宙的状况,并可能揭示影响星系形成的关键因素。随着观测数据的增加,这些模拟将成为连接理论与实际观察的重要工具,进一步推动宇宙学的发展。